这是什么: CSP-J 第一轮最近 7 套真题(2019–2025)的完整题面 + 逐题答案与解析。共 140 题 / 300 小题。
⚠️ 不要一上来就翻答案。 这七套是你手上最珍贵的东西,翻一次就少一次。
正确的用法(一次一套):
📝 建议留 2 套不做,留到考前一周当模拟卷(推荐留 2024、2025)。
从 2019 年 CSP 改制起,入门级第一轮的结构就固定了:
| 部分 | 题数 | 分值 | 说明 |
|---|---|---|---|
| 一、单项选择题 | 15 | 2 分 × 15 = 30 | 常识、数学、数据结构、语法 |
| 二、阅读程序 | 3 篇 | 40 | 每篇含判断题(1.5 分)和选择题(3 分) |
| 三、完善程序 | 2 篇 | 每篇 5 空 × 3 分 = 30 | 五选一填空 |
| 100 | 限时 120 分钟 |
📝 阅读程序 + 完善程序 = 70 分,是绝对的大头。见
E9_阅读程序专项.md 和
E10_完善程序专项.md。
一个 位无符号整数可以表示的最大值,最接近下列哪个选项?
A. B. C. D.
答案:A
无符号 位能表示 ,即 。
📝
这两个数背下来:(int
的上限),(unsigned
的上限)。选项里
是有符号 int 的上限,专门放来骗人的。
在 C++ 中,执行
int x = 255; cout << (x & (x - 1));
后,输出的结果是?
A. B. C. D.
答案:B
,,按位与得 。
📝 x & (x-1) 的作用是「抹掉最低位的那个
1」,这是位运算里最常考的一个套路(另一个是
x & (-x) 取出最低位的 1)。所以看到
x & (x-1) 就直接想「少了一个
1」——
有
个
,抹掉最低位剩
。
⚠️ 如果 x & (x-1) == 0,说明
只有一个
,即
是
的幂。这个结论会单独出题。
函数 calc(n) 的定义如下,则 calc(5)
的返回值是多少?( )
int calc(int n) {
    if (n <= 1) return 1;
    if (n % 2 == 0) return calc(n / 2) + 1;
    else return calc(n - 1) + calc(n - 2);
}
A. B. C. D.
答案:B
从小往大算,别从 calc(5) 往下钻:
| 0 | 1 | 2 | 3 | 4 | 5 | |
|---|---|---|---|---|---|---|
calc(n) |
1 | 1 | 2 | 3 | 3 | 6 |
calc(2):偶 → calc(1)+1 = 2calc(3):奇 →
calc(2)+calc(1) = 2+1 = 3calc(4):偶 → calc(2)+1 = 3calc(5):奇 →
calc(4)+calc(3) = 3+3 = 6📝 递归题一律列表格从小往大填,别在脑子里展开调用树——初赛的递归题几乎全都能这么算,而且不会出错。
用 个权值 构造哈夫曼树,该树的带权路径长度是多少?
A. B. C. D.
答案:B
哈夫曼树:每次取最小的两个合并,合并结果放回去。
| 步 | 取出 | 新结点 | 剩下的 |
|---|---|---|---|
| 1 | 10, 12 | 22 | 15, 20, 22, 25 |
| 2 | 15, 20 | 35 | 22, 25, 35 |
| 3 | 22, 25 | 47 | 35, 47 |
| 4 | 35, 47 | 82 | 82 |
。
📝 别去画树再逐个数深度,太慢也容易错。WPL = 所有「合并出来的新结点」之和——每合并一次就把那个和累加起来,做完就是答案。这是初赛哈夫曼题的标准解法。
在一个有向图中,所有顶点的入度之和等于所有顶点的出度之和,这个总和等于?
A. 顶点数 B. 边数 C. 顶点数 + 边数 D. 顶点数
答案:B
每条有向边给起点贡献 个出度、给终点贡献 个入度。所以入度总和 = 出度总和 = 边数。
📝 对照记:无向图里「所有顶点度数之和 = 边数 × 2」(握手定理)。有向图分开算就各等于边数,别把两条搞混。
从 位男生和 位女生中选出 人组成一个学习小组,要求学习小组中男生和女生都有。有多少种不同的选法?
A. B. C. D.
答案:C
正难则反:总选法减去「全男」和「全女」。
📝 看到「都有」「至少一个」,先想补集。 直接分类(1男3女+2男2女+3男1女)也能做,但要算三次还容易漏,考场上慢一倍。
⚠️ 选项里的 就是「忘了减」, 是「只减了全男」——出题人把每一种漏算都做成了一个选项。
假设
都是布尔变量,逻辑表达式
(a && b) || (!c && a)
的值与下列哪个表达式不始终相等?
A. a && (b || !c) B.
(a || !c) && (b || !c) && (a || a) C.
a && (!b || c) D.
!(!a || !b) || (a && !c)
答案:C
原式 (提取公因子 )。
逐项验(已用真值表全部八种取值核对):
| 选项 | 结论 |
|---|---|
| A. `a && (b | |
| B. `(a | |
| **C. `a && (!b | |
| D. `!(!a |
📝 逻辑题不要硬推,直接列真值表。 三个变量只有 行,画完一定不会错;反倒是「一眼看出来」最容易翻车。
已知 , ,并且对于所有 有 。那么 的值是多少?
A. B. C. D.
答案:D
,算前几项找周期:
n :  0  1  2  3  4  5  6  7  8  9 10 11 12 13 14 15 | 16 17
f :  1  1  2  3  5  1  6  0  6  6  5  4  2  6  1  0 |  1  1
第 项开始重复 —— 周期是 。,所以 。
📝 看到「取模的递推」求很大的下标,一定是找周期。 做法固定:一直往下算,直到出现连续两项和开头一样(本题是 ),中间隔了多少就是周期。
⚠️ 求余数时用 而不是 ——数列是从 开始编号的,别错位。
下列关于 C++ string 类的说法,正确的是?
A. string 对象的长度在创建后不能改变。 B. 可以使用 + 运算符直接连接一个 string 对象和一个 char 类型的字符。 C. string 的 length() 和 size() 方法返回的值可能不同。 D. string 对象必须以 '\0' 结尾,且这个结尾符计入 length()。
答案:B
| 选项 | 判断 |
|---|---|
| A. 长度创建后不能改变 | ✗ string 就是能变长的,这是它比 char
数组好用的原因 |
B. 可以用 + 连接 string 和
char |
✓ s + 'a'、s += 'a' 都合法 |
C. length() 和 size() 可能不同 |
✗ 两个是同一个函数的两个名字,永远相等 |
D. 必须以 '\0' 结尾且计入 length() |
✗ '\0' 是 C 风格字符数组的规矩;string 的
length() 不含它 |
⚠️ 这是从 char 数组的知识生搬到
string 上会踩的坑,C 和 D
都是这么设计的。记住一句:string 自己管长度,不靠
'\0'。
考虑以下 C++ 函数:
void solve(int &a, int b) {
    a = a + b;
    b = a - b;
    a = a - b;
}
int main() {
    int x = 5, y = 10;
    solve(x, y);
}
在 main 函数调用 solve 后, 和 的值分别是?
A. B. C. D.
答案:C
关键在
void solve(int &a, int b):a
是引用(改了会传回去),b 是副本(改了白改)。
| 语句 | a(就是 x) |
b(副本) |
y |
|---|---|---|---|
| 进入时 | 5 | 10 | 10 |
a = a + b |
15 | 10 | 10 |
b = a - b |
15 | 5 | 10 |
a = a - b |
10 | 5 | 10 |
所以 、。
📝 这段代码本来是「不用临时变量交换两个数」的经典写法,但这里只有一个参数是引用,交换就废了一半。 初赛最爱考的就是这种「看着像交换其实不是」。
⚠️ 看到函数参数先做一件事:把带 &
的圈出来。 不带 &
的,函数里怎么改都跟外面无关。
一个 的棋盘,左上角坐标为 ,右下角为 。一个机器人从 出发,每次只能向右或向下走一格。要到达 ,有多少种不同的路径?
A. B. C. D.
答案:B
从 到 :行从 到 要向下 步,列从 到 要向右 步,共 步,其中挑 步向下:
📝 网格路径题的公式:。 总步数 = 行差 + 列差。
⚠️ 行差是 不是 。 选项里的 、 就是给「把坐标当成步数」的人准备的。棋盘再大()也跟答案无关,那是干扰信息。
某同学用冒泡排序对数组 进行升序排序,请问需要进行多少次元素交换?
A. B. C. D.
答案:B
冒泡排序的交换次数 恒等于数组里的逆序对个数。 的逆序对:
—— 共 6 个。(已实跑冒泡确认交换 次)
📝 背下来:冒泡排序的交换次数 = 逆序对数,因为每交换一次相邻元素恰好消掉一个逆序对。数逆序对比模拟冒泡快得多。
⚠️ 别把「交换次数」和「比较次数」搞混:比较次数固定是 (不加提前退出的话),跟数据长什么样无关。
十进制数 和八进制数 的和用十六进制表示是多少?
A. B. C. D.
答案:A
,。
,所以是 。
📝 进制混合运算的固定套路:全部先转成十进制算,最后再转成题目要的进制。 别想着直接在八进制下做加法。
⚠️ 八进制转十进制的权是 ;十六进制是 。这两串数背熟,初赛每年都用。
一棵包含 个结点的完全二叉树,其叶子结点的数量是多少?
A. B. C. D.
答案:C
完全二叉树 个结点时,有孩子的结点恰好是编号 ,其余全是叶子。
📝 公式:完全二叉树的叶子数 。 是偶数时正好是 ,奇数时是 。
⚠️ 选项里的 是「满二叉树最后一层」,、 是差一。完全二叉树 ≠ 满二叉树:满二叉树每层都填满(结点数是 ),完全二叉树只要求最后一层靠左连续。
给定一个初始为空的整数栈 和一个空的队列 。我们按顺序处理输入的整数队列 。对于队列 中的每一个数,执行以下规则:如果该数是奇数,则将其压入栈 ;如果该数是偶数,且栈 非空,则弹出一个栈顶元素,并加入到队列 的末尾;如果该数是偶数,且栈 为空,则不进行任何操作。当队列 中的所有数都处理完毕后,队列 的内容是什么?
A. B. C. D.
答案:A
老老实实模拟,栈顶写在右边:
| 处理 | 规则 | 栈 | 队列 |
|---|---|---|---|
| 7 | 奇,入栈 | 7 | |
| 5 | 奇,入栈 | 7 5 | |
| 8 | 偶且非空,弹栈顶 5 | 7 | 5 |
| 3 | 奇,入栈 | 7 3 | 5 |
| 1 | 奇,入栈 | 7 3 1 | 5 |
| 4 | 偶且非空,弹栈顶 1 | 7 3 | 5 1 |
| 2 | 偶且非空,弹栈顶 3 | 7 | 5 1 3 |
。
📝 栈/队列的模拟题必须画这张表,一行一步。 想着「在脑子里过一遍」是这类题唯一的失分原因。
⚠️ 注意
一直压在栈底没出来过——选项 D 的 5,1,3,7
就是给「以为最后要清空栈」的人准备的。
#include <algorithm>
#include <cstdio>
#include <cstring>
inline int gcd(int a, int b) {
    if (b == 0) {
        return a;
    }
    return gcd(b, a % b);
}
int main() {
    int n;
    scanf("%d", &n);
    int ans = 0;
    for (int i = 1; i <= n; ++i) {
        for (int j = i + 1; j <= n; ++j) {
            for (int k = j + 1; k <= n; ++k) {
                if (gcd(i, j) == 1 && gcd(j, k) == 1 && gcd(i, k) == 1) {
                    ++ans;
                }
            }
        }
    }
    printf("%d\n", ans);
    return 0;
}16.(
分)当输入为
时,程序并不会执行第
行的判断语句。( )
17. 将第
行中的 && gcd(i,k)==1 删去不会影响程序运行结果。(
)
18. (错题,请选择 B 获得分数)当输入的
的时候,程序总是输出一个正整数。( )
将第
行的 gcd(b, a%b) 改为 gcd(a, a%b)
后,程序可能出现的问题是( )。
A. 输出的答案大于原答案。
B. 输出的答案小于原答案。
C. 程序有可能陷入死循环。
D. 可能发生整型溢出问题。
当输入为
的时候,输出为( )。
A.
B.
C.
D.
调用
会返回( )。
A.
B.
C.
D.
(1)(1 分)
A. 正确 B. 错误
(2)(1.5 分)
A. 正确 B. 错误
(3)(1.5 分)
A. 正确 B. 错误
(4)(3 分)
A. 输出的答案大于原答案。 B. 输出的答案小于原答案。 C. 程序有可能陷入死循环。 D. 可能发生整型溢出问题。
(5)(3 分)
A. B. C. D.
(6)(3 分)
A. B. C. D.
答案:(1) A (2) B (3) B (4) B (5) D (6) A
程序在数 中两两互质的三元组个数。实测各 的输出:
| 2 | 3 | 4 | 5 | 8 | 10 | |
|---|---|---|---|---|---|---|
| 原程序 | 0 | 1 | 2 | 7 | 25 | 42 |
删掉 && gcd(i,k)==1 |
0 | 1 | 3 | 8 | 35 | 66 |
(1)
正确(A):
时
的循环 for (k = j+1; k <= 2; ...)
一次都进不去(
时
从
起步),所以那句 if 判断根本没执行过。输出
。
(2) 错误(B): 时原程序 、删掉后 ——多出来的是 :、,但 。两两互质 ≠ 相邻互质。
(3) 送分题:洛谷标注「错题,请选择 B 获得分数」。
(4) 输出的答案小于原答案(B):改成
gcd(a, a % b) 后,a 永远不变、b
每轮严格变小,最后 b 归零返回的就是最初的
a——也就是 gcd(i,j) 直接返回
i。于是条件退化成 i==1 && j==1,而
永远不可能同时成立,输出恒为
(
从
到
实测全是
)。
⚠️
C(死循环)是最诱人的错误答案,但实测跑不出死循环。
因为 a % b < b
恒成立(
时 a % b = a < b),b
单调递减且非负,一定会到
。「递归写错了」不等于「一定死循环」——这题就在考这个。
(5) 25(D): 实测输出 。
(6) 6(A):。 是最小公倍数,放来骗人的。
⚠️ 题面里的行号(第 7 行、第 16
行)对应的是原卷排版,洛谷转录时缩进变了,行号对不上。
按文字描述定位:「第 7 行」= gcd 里那句递归调用,「第 16
行」= 那句 if (gcd(i,j)==1 && ...)。
#include <algorithm>
#include <cstdio>
#include <cstring>
#define ll long long
int n, k;
int a[200007];
int ans[200007];
int main() {
    scanf("%d%d", &n, &k);
    for (int i = 1; i <= n; ++i) {
        scanf("%d", &a[i]);
    }
    std::sort(a + 1, a + n + 1);
    n = std::unique(a + 1, a + n + 1) - a - 1;
    for (int i = 1, j = 0; i <= n; ++i) {
        for (; j < i && a[i] - a[j + 1] > k; ++j)
            ;
        ans[i] = ans[j] + 1;
    }
    printf("%d\n", ans[n]);
    return 0;
}3 1 3 2 1 时,输出结果为
。(
)n = std::unique(a + 1, a + n + 1) - a - 1;
删去后,有可能出现与原本代码不同的输出结果。( )假设输入的
数组和
均为正整数,执行第 18 行代码时,一定满足的条件不包括( )。
A.
B.
C.
D.
当输入的
、、
时,输出为( )。
A.
B.
C.
D.
假设输入的
数组和
均为正整数,但
数组不一定有序,则若误删去第 13 行的
std::sort(a + 1, a + n + 1);,程序有可能出现的问题有(
)。
A. 输出的答案比原本答案更大
B. 输出的答案比原本答案更小
C. 出现死循环行为
D. 以上均可能发生
(1)(1.5 分)
A. 正确 B. 错误
(2)(1.5 分)
A. 正确 B. 错误
(3)(1.5 分)
A. 正确 B. 错误
(4)(3 分)
A. B. C. D.
(5)(3 分)
A. B. C. D.
(6)(3 分)
A. 输出的答案比原本答案更大 B. 输出的答案比原本答案更小 C. 出现死循环行为 D. 以上均可能发生
答案:(1) A (2) A (3) B (4) B (5) A (6) B
程序先排序去重,再用双指针贪心:把这些数分成尽量少的段,每段内最大值减最小值不超过 ,输出段数。
(1) 正确(A):输入 3 1 /
3 2 1 → 排序去重得
,
→ 分成
和
两段。实测输出 2。
(2) 正确(A):至少
段;最多每个数各成一段。实测 5 1 / 1 3 5 7 9
输出
(上界),5 2
/ 1 1 1 1 1 输出
(下界)。
(3) 错误(B):穷举了
、值
、
的全部情况,一个反例都没有。
原因:重复的数排序后必定相邻,a[i] - a[j+1] 在它们之间是
,永远不会
,所以不会多切一刀,ans
也就不变。
📝 去重在这里只是提速,不改变答案。 这题在考「你能不能分清哪些代码是必要的、哪些只是优化」。
(4)
a[i] - a[j] > k(B):这一条不一定满足——当
j == 0 时 a[0] 是全局数组的初值
,比如只有一个数
、,此时
a[1] - a[0] = 1,并不
。其余三个都恒成立(j
最多停在 i-1,所以
j < i < = n;数组严格递增所以
a[j] < a[i])。
(5) 34(A):、,每段最多装 三个数,。实测输出 34。
(6) 输出的答案比原本答案更小(B):穷举 、值 、 的全部无序输入,「更小」出现 359044 次,「更大」出现 0 次。
⚠️ C(死循环)同样是个陷阱:内层 for
只让 j 单调 ++ 且有 j < i
兜底,跑不出死循环。别一看到「删了
sort」就条件反射选「以上均可能」。
#include <algorithm>
#include <cstdio>
#include <cstring>
#define ll long long
int f[5007][5007];
int a[5007], b[5007];
int n;
int main() {
    scanf("%d", &n);
    for (int i = 1; i <= n; ++i) {
        scanf("%d", &a[i]);
    }
    for (int i = 1; i <= n; ++i) {
        scanf("%d", &b[i]);
    }
    for (int i = 1; i <= n; ++i) {
        for (int j = 1; j <= n; ++j) {
            f[i][j] = std::max(f[i][j], std::max(f[i - 1][j], f[i][j - 1]));
            if (a[i] == b[j]) {
                f[i][j] = std::max(f[i][j], f[i - 1][j - 1] + 1);
            }
        }
    }
    printf("%d\n", f[n][n]);
    return 0;
}4 1 2 3 4 1 3 2 2 时,输出为 2。( )f[i][j] = std::max(f[i][j], std::max(f[i-1][j], f[i][j-1]));
删去后,并不影响程序运行结果。( )输出的答案满足的性质有( )。
A. 小于等于
B. 大于等于
C. 不一定大于等于
D. 以上均是
如果在 16 行的循环前加上以下两行:
std::sort(a+1, a+n+1);
std::sort(b+1, b+n+1);
则答案会( )。
A. 变大或不变
B. 变小或不变
C. 一定变大
D. 不变
(1)(1.5 分)
A. 正确 B. 错误
(2)(1.5 分)
A. 正确 B. 错误
(3)(1.5 分)
A. 正确 B. 错误
(4)(3 分)
A. 小于等于 B. 大于等于 C. 不一定大于等于 D. 以上均是
(5)(3 分)
A. 变大或不变 B. 变小或不变 C. 一定变大 D. 不变
(6)(3 分)
A. 求 数组去重后的长度 B. 求 数组的最长上升子序列 C. 求 数组的长度 D. 求 数组的最大值
答案:(1) A (2) A (3) B (4) D (5) A (6) B
标准的最长公共子序列(LCS)
动态规划,f[i][j] = a 前
个与 b 前
个的 LCS 长度。
(1) 正确(A):4 / 1 2 3 4 / 1 3 2 2 的
LCS 是
或
,长度
。实测输出
2。
(2) 正确(A):那句
f[i][j] = max(f[i][j], max(f[i-1][j], f[i][j-1])) 保证了
f 沿两个方向都单调不减,所以右下角 f[n][n]
是全表最大值。
(3) 错误(B):删掉那一行,实测
4 / 1 2 3 4 / 1 3 2 2 从
变成 0。因为没有它,f[i-1][j-1]
的值传不上来,只有 a[i]==b[j] 且恰好在对角线上才累加。
📝 这一行才是 LCS 的主体(「不匹配就继承」),不是可有可无的初始化。
(4) 以上均是(D):LCS 长度
✓;
✓;可以等于
(实测
1 2 3 4 与 5 6 7 8 输出
),所以「不一定
」也对。
(5) 变大或不变(A):实测四组,、、、、,没有一组变小。道理:两个序列都排好序后,LCS 就等于两个可重集合的交集大小,而那是任何排列下 LCS 的上限。
(6) 求 b
数组的最长上升子序列(B):a 是严格递增的
,所以公共子序列必然严格递增,LCS
就退化成 b 的最长上升子序列。实测
b={3,3,1,1,2} 输出
(即
),b={5,4,3,2,1}
输出
。
⚠️ 洛谷标注这一小题「在原卷中被删除」,练习时可以做,但别拿它算分。
(1)(字符串解码)“行程长度编码”(Run-Length
Encoding)是一种无损压缩算法,常用于压缩重复字符较多的数据,以减少存储空间。假设原始字符串不包含数字字符。压缩规则如下:i)
如果原始字符串中一个字符连续出现
次(),在压缩字符串中它被表示为“字符
+ 数字
”。例如,编码
A12 代表
个连续的字符 A。ii) 如果原始字符串中一个字符只出现
次,在压缩字符串中它就表示为该字符本身。例如,编码 B 代表
个字符 B。
以下程序实现读取压缩字符串并输出其原始的、解压后的形式。试补全程序。
#include <cctype>
#include <iostream>
#include <string>
using namespace std;

int main() {
    string z;
    cin >> z;
    string s = "";

    for (int i = 0; i < z.length(); ) {
        char ch = z[i];

        if (__①__ && isdigit(z[i + 1])) {
            i++;
            int count = 0;
            while (i < z.length() && isdigit(z[i])) {
                count = __②__;
                i++;
            }
            for (int j = 0; j < __③__; ++j) {
                s += ch;
            }
        } else {
            s += __④__;
            __⑤__;
        }
    }

    cout << s << endl;
    return 0;
}
①处应填( )
A. i < z.length()
B. i - 1 >= 0
C. i + 1 < z.length()
D. isdigit(z[i])
②处应填( )
A. count + (z[i] - '0')
B. count * 10 + (z[i] - '0')
C. z[i] - '0'
D. count + 1
③处应填( )
A. count - 1
B. count
C. 10
D. z[i] - '0'
④处应填( )
A. z[i+1]
B. ch
C. z.back()
D. (char)z[i] + 1
⑤处应填( )
A. i--
B. i = i + 2
C. i++
D. // 不执行任何操作
(1)(3 分)
A. i < z.length() B. i - 1 >= 0 C.
i + 1 < z.length() D. isdigit(z[i])
(2)(3 分)
A. count + (z[i] - '0') B.
count * 10 + (z[i] - '0') C. z[i] - '0' D.
count + 1
(3)(3 分)
A. count - 1 B. count C. 10 D.
z[i] - '0'
(4)(3 分)
A. z[i+1] B. ch C. z.back() D.
(char)z[i] + 1
(5)(3 分)
A. i-- B. i = i + 2 C. i++ D.
// 不执行任何操作
答案:① C ② B ③ B ④ B ⑤ C
行程长度解码:读到「字符 + 数字」就把该字符重复若干次,否则原样输出一个字符。
| 空 | 填 | 为什么 |
|---|---|---|
| ① | i + 1 < z.length() |
下一句要访问
z[i+1],先确认它存在再访问 |
| ② | count * 10 + (z[i] - '0') |
多位数字要逐位「进位累加」 |
| ③ | count |
重复 count 次 |
| ④ | ch |
单字符情形,原样接上 |
| ⑤ | i++ |
往后挪一格,否则原地打转 |
逐个选项实测(输入 A12B,正确输出
AAAAAAAAAAAAB,共
个 A):
| 改动 | 实测输出 | 死在哪 |
|---|---|---|
①填 isdigit(z[i]) |
A11B |
字符位不是数字,压缩段永远进不去 |
②填 count + (z[i]-'0') |
AAAB |
,没进位 |
②填 z[i]-'0' |
AAB |
只留最后一位 |
③填 count - 1 |
11 个 A | 差一 |
③填 10 |
10 个 A | 固定 10 次 |
④填 z[i+1] |
少字符 / 越位 | 拿错了字符 |
⑤填 i-- 或「不执行」 |
死循环 | i 不前进 |
⑤填 i = i + 2 |
AB → A |
一次跳两格,吞字符 |
⚠️ ①填 i < z.length()
实测输出也完全正确——因为 C++11 起 string 的
s[s.size()] 合法且返回
'\0',isdigit('\0')
为假。但出题人要的是
C:i + 1 < z.length()
才是「访问前先检查边界」的正确写法。
📝 这是完善程序最值钱的一条经验:先看这个空后面紧跟着哪次数组/字符串访问,空里填的多半就是那次访问的边界保护。
(2)(精明与糊涂)有
个人,分为两类:
i) 精明人:永远能正确判断其他人是精明还是糊涂;
ii)糊涂人:判断不可靠,会给出随机的判断。
已知精明人严格占据多数,即如果精明人有 个,则满足 。
你只能通过函数 让第 个人判断第 个人:返回 表示判断结果为“精明人”;返回 表示判断结果为“糊涂人”。你的目标是,通过这些互相判断,找出至少一个百分之百确定的精明人。同时,你无需关心 的内部实现。
以下程序利用“精明人占多数”的优势。设想一个“消除”的过程,让人们互相判断并进行抵消。经过若干轮抵消后,最终留下的候选人必然属于多数派,即精明人。
例如,假设有三人 。如果 说 是糊涂人,而 也说 是糊涂人,则 和 至少有一个是糊涂人。程序将同时淘汰 和 。由于三人里至少有两个精明人,我们确定 是精明人。
试补全程序。
#include <iostream>
#include <vector>
using namespace std;

int N;
bool query(int i, int j);

int main() {
    cin >> N;

    int candidate = 0;
    int count = __①__;
    for (int i = 1; i < N; ++i) {
        if (__②__) {
            candidate = i;
            count = 1;
        } else {
            if (__③__) {
                __④__;
            } else {
            count++;
            }
        }
    }
    cout << __⑤__ << endl;
    return 0;
}
①处应填( )
A. 0
B. 1
C. N
D. -1
②处应填( )
A. count < 0
B. count == 1
C. count == 0
D. query(candidate, i) == false
③处应填( )
A. query(candidate, i) == false
B. query(i, candidate) == true
C.
query(candidate, i) == false && query(i, candidate) == false
D.
query(candidate, i) == false || query(i, candidate) == false
④处应填( )
A. count--
B. break
C. count++
D. candidate = i
⑤处应填( )
A. N - 1
B. count
C. candidate
D. 0
(1)(3 分)
A. 0 B. 1 C. N D.
-1
(2)(3 分)
A. count < 0 B. count == 1 C.
count == 0 D. query(candidate, i) == false
(3)(3 分)
A. query(candidate, i) == false B.
query(i, candidate) == true C.
query(candidate, i) == false && query(i, candidate) == false
D.
query(candidate, i) == false || query(i, candidate) == false
(4)(3 分)
A. count-- B. break C. count++
D. candidate = i
(5)(3 分)
A. N - 1 B. count C. candidate
D. 0
答案:① B ② C ③ D ④ A ⑤ C
这是摩尔投票法(Boyer–Moore 多数投票):擂主 + 计数器,意见相左就同归于尽,最后活下来的必属多数派。
| 空 | 填 | 为什么 |
|---|---|---|
| ① | 1 |
一开始 号是擂主,他自己算 票 |
| ② | count == 0 |
票数归零 = 擂主被打光了,换人 |
| ③ | query(candidate,i)==false || query(i,candidate)==false |
只要有一方说对方糊涂,两人里必有一个糊涂 |
| ④ | count-- |
同归于尽,抵消一票 |
| ⑤ | candidate |
输出最后的擂主 |
随机化实测(精明人位置随机打乱、精明人严格过半、,各跑 4000 次):
| 填法 | 4000 次里选错 |
|---|---|
| 标准答案 | 0 次 |
①填 0 |
162 次 |
②填 count == 1 |
869 次 |
②填 query(candidate,i)==false |
1390 次 |
③把 || 改成 && |
420 次 |
④填 count++ |
868 次 |
④填 candidate = i |
872 次 |
④填 break |
885 次 |
📝 ③ 为什么必须是「或」不是「且」:糊涂人的判断是乱给的,他可能碰巧说擂主是精明人。用「且」的话,只要糊涂人随口夸擂主一句就抵消不掉,多数派的优势就守不住了——实测 4000 次里错 420 次。
⚠️
摩尔投票是初赛完善程序的常客(求「出现次数超过一半的数」也是它)。背下这个骨架:擂主
+ 计数器,相同就 ++,不同就
--,归零就换人。
32 位 int 类型的存储范围是( )?
A. -2147483647 ~ +2147483647 B. -2147483647 ~ +2147483648 C. -2147483648 ~ +2147483647 D. -2147483648 ~ +2147483648
答案:C
位有符号 int 用补码存储,范围是
,即
。
📝 负数比正数多一个,这是补码的直接后果: 占了正数那一侧的一个位置。背这个口诀:负的那头是整的(),正的那头减一()。
⚠️ A、B、D 三个选项都是「两头对称」或「正的那头多一个」,全是同一个误解的不同变体。
计算 的结果,并选择答案的十进制值:( )
A. 13 B. 14 C. 15 D. 16
答案:A
先把所有数换成十进制再算:
📝 混进制运算的唯一正确姿势:全转十进制 → 算 → 需要的话再转回去。 想在原进制下直接加减乘,考场上百分之百会错。
⚠️ 最容易错的是 (不是 )和 (跟 恰好相等,出题人故意的)。
某公司有 名员工,分为 个部门:A 部门有 名员工,B 部门有 名员工,C 部门有 名员工。现需要从这 名员工中选出 名组成一个工作小组,且每个部门至少要有 人。问有多少种选择方式?( )
A. 120 B. 126 C. 132 D. 238
答案:B
每部门至少 人、共选 人,人数分配只有三种:
| A(4人) | B(3人) | C(3人) | 算式 | 结果 |
|---|---|---|---|---|
| 2 | 1 | 1 | 54 | |
| 1 | 2 | 1 | 36 | |
| 1 | 1 | 2 | 36 | |
| 合计 | 126 |
📝 「每组至少一个」的题:先枚举人数分配方案,再对每种方案用乘法原理。 分配方案很少(这里只有 3 种),列出来比想公式快。
⚠️ 选项 A 的 是 之类的错误补集算法;这题不能用补集,因为「至少一个」的反面有三种情况还会重叠,比正面算还麻烦。
以下哪个序列对应数字 至 的 位二进制格雷码(Gray code)?( )
A. 0000, 0001, 0011, 0010, 0110, 0111, 0101, 1000 B. 0000, 0001, 0011, 0010, 0110, 0111, 0100, 0101 C. 0000, 0001, 0011, 0010, 0100, 0101, 0111, 0110 D. 0000, 0001, 0011, 0010, 0110, 0111, 0101, 0100
答案:D
格雷码的定义:相邻两个码只差一个二进制位。公式 :
0->0000  1->0001  2->0011  3->0010
4->0110  5->0111  6->0101  7->0100
D 完全吻合。
1000:从 0101 到
1000 变了 3 位 ✗0100, 0101)✗0010 → 0100 变了 2 位 ✗📝 不必背格雷码表,只要逐对检查「是不是只差一位」,四个选项十几秒就能筛掉三个。
⚠️ 题面说「 至 」但每个选项只列了 个码(对应 ),按 判断即可。
记 1KB 为 1024 字节(byte),1MB 为 1024KB,那么 1MB 是多少二进制位(bit)?( )
A. 1000000 B. 1048576 C. 8000000 D. 8388608
答案:D
⚠️ 这题的坑就是 B: 是字节数,不是位数。题目问的是 bit。看到 bit / byte 一定要停一下,差了 倍。
📝 记住 1 字节 = 8 位,,。
以下哪个不是 C++ 中的基本数据类型?( )
A. int B. float C. struct D. char
答案:C
C++
的基本(内置)数据类型:int、long long、float、double、char、bool。
struct
是关键字,用来自己定义构造类型,本身不是一种数据类型。
📝
分清两类:基本类型是语言自带的(int/char/float/double/bool);构造类型是你拼出来的(数组、struct、union、指针)。
以下哪个不是 C++ 中的循环语句?( )
A. for B. while C. do-while D. repeat-until
答案:D
C++
的三种循环:for、while、do-while。repeat-until
是 Pascal 的语法,C++ 里没有。
📝 C++ 里跟 repeat-until 最像的是
do-while,但条件相反:repeat ... until (条件)
是「条件成立就停」,do {...} while (条件)
是「条件成立就继续」。
⚠️ do-while
是初赛常客(考它的分号、考它至少执行一次)。别因为平时不写就不认识。
在 C/C++ 中,(char)('a' + 13) 与下面的哪一个值相等?(
)
A. 'm' B. 'n' C. 'z' D. 'l'
答案:B
'a' 的 ASCII 码是
,,而
对应 'n'。
📝 ASCII 三个基准值背死:'0' =
48,'A' = 65,'a' = 97。其余全靠加减。
⚠️ 数字母时容易差一:'a' 是第 1 个,加 13 落在第 14
个字母 —— a,b,c,d,e,f,g,h,i,j,k,l,m,n。用 ASCII
码算比数字母可靠。
假设有序表中有 个元素,则用二分法查找元素 最多需要比较( )次。
A. 25 B. 10 C. 7 D. 1
答案:B
二分查找每次把范围砍半, 个元素最多需要 次。
验证:。
📝 口诀:、、。 这三个近似值在初赛(估比较次数)和复赛(估复杂度)都天天用。
⚠️ 选项 A 的 是 之类的瞎算,C 的 是 。
下面的哪一个不是操作系统名字?( )
A. Notepad B. Linux C. Windows D. macOS
答案:A
Notepad(记事本)是 Windows 里的一个应用程序,不是操作系统。Linux、Windows、macOS 都是操作系统。
📝 初赛的计算机常识题基本就在这几组词里打转:操作系统(Windows / Linux / macOS / Android / iOS / UNIX)、应用软件(记事本 / Office / 浏览器)、编程语言、浏览器。分清哪个是哪类就够了。
在无向图中,所有顶点的度数之和等于( )。
A. 图的边数 B. 图的边数的两倍 C. 图的顶点数 D. 图的顶点数的两倍
答案:B
握手定理:无向图中每条边给它的两个端点各贡献 度,所以
📝 和有向图对照记(CSP 2025 第 5 题正好考了有向图):
| 结论 | |
|---|---|
| 无向图 | 度数之和 = 边数 × 2 |
| 有向图 | 入度之和 = 出度之和 = 边数 |
⚠️ 由此还能推出一个常考结论:无向图中度数为奇数的顶点必定有偶数个。
已知二叉树的前序遍历为 ,中序遍历为 ,请问该二叉树的后序遍历结果是?( )
A. B. C. D.
答案:A
前序 、中序 :
        A
      /   \
     B     C
    / \   / \
   D   E F   G
后序(左 → 右 → 根):
📝 固定套路:前序给根,中序给左右分界。 递归两三层就出来了。
⚠️ 后序的最后一个一定是根——先看这一位就能砍掉 B、D 两个选项(它们结尾是 )。这是最快的排除法。
给定一个空栈,支持入栈和出栈操作。若入栈操作的元素依次是 ,其中 最先入栈, 最后入栈,下面哪种出栈顺序是不可能的?( )
A. 6 5 4 3 2 1 B. 1 6 5 4 3 2 C. 2 4 6 5 3 1 D. 1 3 5 2 4 6
答案:D
用栈模拟(能弹就弹,不能弹就继续压):
| 选项 | 结果 |
|---|---|
A. 6 5 4 3 2 1 |
可能(全压完再全弹) |
B. 1 6 5 4 3 2 |
可能 |
C. 2 4 6 5 3 1 |
可能 |
D. 1 3 5 2 4 6 |
不可能 |
D 卡在哪:弹 、弹 (此时栈内 )、弹 (此时栈内 ,栈顶是 )→ 下一个要弹 ,但 被压在 下面,出不来。
📝 判定口诀:出栈序列中,某个数后面比它小的那些数,必须是递减的。 D 里 后面跟着 —— 比 小却排在前面,违规。
⚠️ 不确定就老实模拟,六个数最多十几步,比套规律稳。
有 个男生和 个女生站成一排,规定 个女生必须相邻。问有多少种不同的排列方式?( )
A. 种 B. 种 C. 种 D. 种
答案:A
捆绑法: 个女生必须相邻 → 把她们看成一个整体。
📝 「必须相邻」用捆绑法(乘内部排列),「不能相邻」用插空法(先排其他人,再往空隙里插)。这两句话记住,这类题就没有第三种花样。
⚠️ 选项 B 的 是「忘了男生只有 5 个」,D 的 是漏乘了一部分。
编译器的主要作用是什么?( )
A. 直接执行源代码 B. 将源代码转换为机器代码 C. 进行代码调试 D. 管理程序运行时的内存
答案:B
编译器把源代码翻译成机器代码(目标代码)。
📝 编译 vs 解释(初赛高频对照):
| 编译型 | 解释型 | |
|---|---|---|
| 做法 | 整个程序先翻译成机器码,再运行 | 一边读一边执行 |
| 代表 | C、C++ | Python、JavaScript |
| 速度 | 运行快 | 运行慢 |
| 报错 | 编译时就能查出语法错 | 运行到那一行才报错 |
⚠️ A(直接执行源代码)说的是解释器,D(管内存)说的是操作系统/运行时。
#include <iostream>
using namespace std;

bool isPrime(int n) {
    if (n <= 1) {
        return false;
    }
    for (int i = 2; i * i <= n; i++) {
        if (n % i == 0) {
            return false;
        }
    }
    return true;
}

int countPrimes(int n) {
    int count = 0;
    for (int i = 2; i <= n; i++) {
        if (isPrime(i)) {
            count++;
        }
    }
    return count;
}

int sumPrimes(int n) {
    int sum = 0;
    for (int i = 2; i <= n; i++) {
        if (isPrime(i)) {
            sum += i;
        }
    }
    return sum;
}

int main() {
    int x;
    cin >> x;
    cout << countPrimes(x) << " " << sumPrimes(x) << endl;
    return 0;
}isPrime(i) 函数中的条件改为
i<=n/2,输入
时, countPrimes(20) 的输出将变为
。()sumPrimes 函数计算的是从
到
之间的所有素数之和。sumPrimes(50) 的输出为( )。for (int i = 2; i * i <= n; i++) 改为
for (int i = 2; i <= n; i++),输入
时,程序的输出( )。(1)(1.5 分)
A. 正确 B. 错误
(2)(1.5 分)
A. 正确 B. 错误
(3)(1.5 分)
A. 正确 B. 错误
(4)(3 分)
A. 1060 B. 328 C. 381 D. 275
(5)(3 分)
A. 将不能正确计算 以内素数个数及其和 B. 仍然输出 和 C. 输出 和 D. 输出结果不变,但运行时间更短
答案:(1) A (2) B (3) A (4) B (5) A
程序统计 的素数个数与素数之和。实测输出:
| 输入 | 原程序 | 把判断条件改成 i <= n/2 |
改成 i <= n |
|---|---|---|---|
| 10 | 4 17 |
4 17 |
0 0 |
| 20 | 8 77 |
8 77 |
0 0 |
| 50 | 15 328 |
15 328 |
0 0 |
(1)
正确(A):
以内素数是
,共
个,和为
。实测
4 17。
(2) 错误(B):i <= n/2
依然是一个正确的素数判定(只是慢),实测
countPrimes(20) 还是
8(),不是
。
📝 注意
、
时 n/2 是
,循环一次都不进,直接返回
true——恰好正确。 这是这题最容易想岔的地方。
(3) 正确(A):sumPrimes 确实是
全部素数之和。
(4) 328(B): 以内素数之和 。实测确认。
(5) 将不能正确计算(A):改成 i <= n
后,循环会走到 i == n,而 n % n == 0
恒成立,于是每个数都被判成合数,实测输出
0 0。
⚠️ i * i <= n 不能随手改成
i <= n。 前者到
就停(正确且快),后者不但慢,还因为把
自己算进除数而彻底错掉。改成 i < n
才是「慢但对」。
#include <iostream>
#include <vector>
using namespace std;

int compute(vector<int>& cost) {
    int n = cost.size();
    vector<int> dp(n+1, 0);
    dp[1] = cost[0];
    for (int i = 2; i <= n; i++) {
        dp[i] = min(dp[i-1], dp[i-2]) + cost[i-1];
    }
    return min(dp[n], dp[n-1]);
}

int main() {
    int n;
    cin >> n;
    vector<int> cost(n);
    for (int i = 0; i < n; i++) {
        cin >> cost[i];
    }
    cout << compute(cost) << endl;
    return 0;
}cost 数组为
时,程序的输出为
。(
)dp[i-1] 改为
dp[i-3],程序可能会产生编译错误。( )cost 数组中最小的元素。( )cost 数组为
时,程序的输出为( )。cost 数组为
,程序的输出为(
)。min(dp[i-1], dp[i-2]) + cost[i-1] 修改为
dp[i-1] + cost[i-2],输入 cost 数组为
时,程序的输出为( )。(1)(1.5 分)
A. 正确 B. 错误
(2)(1.5 分)
A. 正确 B. 错误
(3)(2 分)
A. 正确 B. 错误
(4)(3 分)
A. 6 B. 7 C. 8 D. 9
(5)(4 分)
A. 25 B. 30 C. 35 D. 40
(6)(3 分)
A. 10 B. 15 C. 20 D. 25
答案:(1) A (2) B (3) B (4) A (5) B (6) A
这是「最小花费爬楼梯」:dp[i] = 站上第
级的最小花费,每次可从前一级或前两级上来。实测:
输入 cost |
原程序 | 改成 dp[i-1] + cost[i-2] |
|---|---|---|
{10,15,20} |
15 | 20 |
{1,100,1,1,1,100,1,1,100,1} |
6 | 207 |
{10,15,30,5,5,10,20} |
30 | 75 |
{5,10,15} |
15 | 10 |
(1) 正确(A):{10,15,20} 实测输出
15。
(2) 错误(B):dp[i-3]
语法上完全合法,编译不会报错——它只是会在
时访问 dp[-1] 造成运行期越界。
⚠️ 「越界」和「编译错误」是两回事。 数组下标是负数,编译器管不着;出事在运行时。这是初赛判断题的常客。
(3) 错误(B):反例就在眼前——{10,15,20}
的最小元素是
,程序输出
。
(4) 6(A):经典样例,走 共 。实测确认。
(5) 30(B):实测 {10,15,30,5,5,10,20}
输出 30。
(6) 10(A):改成 dp[i-1] + cost[i-2]
后,{5,10,15} →
dp[1]=5、dp[2]=5+5=10、dp[3]=10+10=20,返回
min(dp[3], dp[2]) = 10。实测确认。
#include <iostream>
#include <cmath>
using namespace std;

int customFunction(int a, int b) {
    if (b == 0) {
        return a;
    }
    return a + customFunction(a, b-1);
}

int main() {
    int x, y;
    cin >> x >> y;
    int result = customFunction(x, y);
    cout << pow(result, 2) << endl;
    return 0;
}2 3 时,customFunction(2, 3)
的返回值为
。(
)customFunction(a, b) 会陷入无限递归。( )5 4 时,customFunction(5, 4)
的返回值为( )。x=3 和 y=3,则程序的最终输出为(
)。customFunction 函数改为
return a + customFunction(a-1, b-1);,并输入
3 3,则程序的最终输出为( )。(1)(1.5 分)
A. 正确 B. 错误
(2)(1.5 分,多选)
A. 正确 B. 错误
(3)(1.5 分,多选)
A. 正确 B. 错误
(4)(3 分)
A. 5 B. 25 C. 250 D. 625
(5)(3 分)
A. 27 B. 81 C. 144 D. 256
(6)(4 分)
A. 9 B. 16 C. 25 D. 36
答案:(1) B (2) A 和 B 都选 (3) A 和 B 都选 (4) B (5) C (6) D
customFunction(a, b) 递归
次、每次加一个 a,所以它等于
。主函数输出的是
pow(result, 2)。实测:
| 输入 | 原程序 f |
输出 pow(f,2) |
改成 customFunction(a-1, b-1) |
|---|---|---|---|
2 3 |
8 | 64 | f=2, 输出 4 |
5 4 |
25 | 625 | f=15, 输出 225 |
3 3 |
12 | 144 | f=6, 输出 36 |
(1)
错误(B):customFunction(2,3) = 2 \times 4 = 8,不是
。
是 pow(8,2)
的结果——题目问的是「函数的返回值」,不是「程序的输出」。
⚠️ 这是本题最狠的一刀。 看清楚问的是「返回值」还是「输出」,两者差一个平方。
(2)(3) 洛谷标注为错题,要求同时选【正确】和【错误】才能拿到对应分数。
(就题论题:
为负数时 b == 0
永远不成立,确实会无限递归直到栈溢出;
越大递归层数越多,运行时间确实越长。两句本身都成立。)
(4) 25(B):。实测确认。
(5) 144(C):,。实测确认。
(6) 36(D):改成
a + customFunction(a-1, b-1) 后是
(每层
a 也减
),。实测确认。
📝 递归题先写出通项:原式 ,改后 。写出来比一层层展开快得多。
(判断平方数) 问题:给定一个正整数 ,希望判断这个数是否为完全平方数,即存在一个正整数 ,使得 的平方为 。
试补全程序。
#include<iostream>
#include<vector>
using namespace std;

bool isSquare(int num) {
    int i = ___①___;
    int bound = ___②___;
    for (; i <= bound; ++i) {
        if (___③___) {
            return ___④___;
        }
    }
    return___⑤___;
}

int main() {
    int n;
    cin >> n;
    if (isSquare(n)) {
        cout << n << " is a square number" << endl;
    } else {
        cout << n << " is not a square number" << endl;
    }
    return 0;
}1234(int)floor(sqrt(num))-1(int)floor(sqrt(num))floor(sqrt(num/2))-1floor(sqrt(num/2))num = 2 * inum == 2 * inum = i * inum == i * inum = 2 * inum == 2 * itruefalsenum = i * inum != i * itruefalse(1)(3 分)
A. 1 B. 2 C. 3 D.
4
(2)(3 分)
A. (int)floor(sqrt(num))-1 B.
(int)floor(sqrt(num)) C. floor(sqrt(num/2))-1
D. floor(sqrt(num/2))
(3)(3 分)
A. num = 2 * i B. num == 2 * i C.
num = i * i D. num == i * i
(4)(3 分,多选)
A. num = 2 * i B. num == 2 * i C.
true D. false
(5)(3 分)
A. num = i * i B. num != i * i C.
true D. false
答案:① A ② B ③ D ④ A 和 C ⑤ D
判断 是不是完全平方数:从 试到 ,看有没有 。
| 空 | 填 | 为什么 |
|---|---|---|
| ① | 1 |
也是完全平方数,必须从 1 开始试 |
| ② | (int)floor(sqrt(num)) |
试到 就够了 |
| ③ | num == i * i |
判断相等要用 == |
| ④ | true(num = 2 * i 也判对) |
找到了就返回真 |
| ⑤ | false |
循环走完没找到 |
逐个选项实测(测 ):
| 改动 | 实测结果 |
|---|---|
①填 2 |
被判成「不是」 —— 上界也是 ,循环一次没进 |
②填 floor(sqrt(num/2)) |
全部判成「不是」 |
④填 num == 2*i |
全判错 |
⑤填 true 或 num != i*i |
全部判成「是」 |
⚠️ ④ 为什么 A
也算对(题面标了「本题有多个可能选项」):return num = 2 * i;
是赋值不是比较,它的值是
,而
所以非零,转成 bool 就是
true——碰巧和标准答案等价。实测
组输入结果与 true 完全一致。
📝 但考场上请填 true。
靠「赋值表达式的值非零」蒙对,换个数据就翻车(比如
可能是
的场合)。这题是特例,不是可以学的写法。
⚠️ ③ 的 = 与
==:if (num = i * i)
能编译、能运行、但恒为真(除非
)。这是
C++ 最经典的坑,初赛年年考。
(汉诺塔问题) 给定三根柱子,分别标记为 A、B 和 C。初始状态下,柱子 A 上有若干个圆盘,这些圆盘从上到下按从小到大的顺序排列。任务是将这些圆盘全部移到柱子 C 上,且必须保持原有顺序不变。在移动过程中,需要遵守以下规则:
试补全程序。
#include <iostream>
#include <vector>
using namespace std;

void move(char src, char tgt) {
    cout << "从柱子" << src << "挪到柱子" << tgt << endl;
}

void dfs(int i, char src, char tmp, char tgt) {
    if (i == ___①___) {
        move(___②___);
        return;
    }
    dfs(i - 1, ___③___);
    move(src, tgt);
    dfs(___⑤___, ___④___);
}

int main() {
    int n;
    cin >> n;
    dfs(n, 'A', 'B', 'C');
}0123src, tmpsrc, tgttmp, tgttgt, tmpsrc, tmp, tgtsrc, tgt, tmptgt, tmp, srctgt, src, tmpsrc, tmp, tgttmp, src, tgtsrc, tgt, tmptgt, src, tmp01i - 1i(1)(3 分)
A. 0 B. 1 C. 2 D.
3
(2)(3 分)
A. src, tmp B. src, tgt C.
tmp, tgt D. tgt, tmp
(3)(3 分)
A. src, tmp, tgt B. src, tgt, tmp C.
tgt, tmp, src D. tgt, src, tmp
(4)(3 分)
A. src, tmp, tgt B. tmp, src, tgt C.
src, tgt, tmp D. tgt, src, tmp
(5)(3 分)
A. 0 B. 1 C. i - 1 D.
i
答案:① B ② B ③ B ④ B ⑤ C
汉诺塔的标准三步:先把上面 个借助目标柱挪到中转柱 → 把最大的那个挪到目标柱 → 再把 个借助起始柱挪到目标柱。
函数签名是
dfs(int i, char src, char tmp, char tgt),对号入座:
| 空 | 填 | 含义 |
|---|---|---|
| ① | 1 |
只剩 个盘就是递归出口 |
| ② | src, tgt |
直接从起始柱挪到目标柱 |
| ③ | src, tgt, tmp |
从 src 挪到 tmp,借助
tgt |
| ④ | tmp, src, tgt |
从 tmp 挪到 tgt,借助
src |
| ⑤ | i - 1 |
规模减一 |
实测(n=3 应为 7 步的标准解):
标准答案     n=1: A->C                                    [1 步]
             n=2: A->B A->C B->C                          [3 步]
             n=3: A->C A->B C->B A->C B->A B->C A->C      [7 步]  ← 正确
③填 src,tmp,tgt  n=2: A->C A->C B->C                      ← 非法,盘子叠错柱子
④填 src,tmp,tgt  n=2: A->B A->C A->C                      ← 非法
①填 0            n=1: 3 步(应为 1 步)                    ← 多做一层
②填 src,tmp      n=1: A->B(应为 A->C)                    ← 挪错柱子
⑤填 i            n=2: 无限递归                             ← 规模不减
📝 递归填空的通用查法:先确认出口(①②),再确认「规模一定要变小」(⑤),最后才推参数顺序(③④)。 出口和规模这两条一错就是死循环或者答案差一倍,比参数顺序好查得多。
⚠️ 三根柱子的顺序千万别用「感觉」。 把签名
(i, src, tmp, tgt)
抄在草稿纸上,然后问自己「这一步是从哪挪到哪、剩下那根当中转」,对着填。
在 C++ 中,下面哪个关键字用于声明一个变量, 其值不能被修改?
A. unsigned B. const C. static
D. mutable
答案:B
const 声明常量,值不能被修改。
| 关键字 | 作用 |
|---|---|
unsigned |
无符号(只表示非负数) |
const |
只读,不能修改 |
static |
静态存储期 / 限定作用域 |
mutable |
恰恰相反——允许在 const
成员函数里修改(提高级内容,认识就行) |
📝 const 在竞赛里最常见的用法是
const int N = 100005; 拿来开数组。
八进制数 和 的和为
A. B. C. D.
答案:D
八进制加法:逢 8 进 1。转十进制算:
📝
也可以直接列竖式在八进制下加(从右往左):,(写
1 进
1),(写
2 进 1)……注意第 1、2 位不进位,从第 3
位起才开始连续进位,所以末两位是 11 而不是
21。
⚠️ 选项 A 的 是「以为每一位都进位」的结果——这题四个选项差别就在末几位,必须真算,不能看个大概。
阅读下述代码,请问修改 data 的 value
成员以存储
,正确的方式是
union Data{
    int num;
    float value;
    char symbol;
};
union Data data;
A. data.value = 3.14; B. value.data = 3.14;
C. data -> value = 3.14; D.
value->data = 3.14;
答案:A
data 是一个 union Data
类型的对象(不是指针),访问成员用 点号
.:data.value = 3.14;
📝 两个箭头的规矩:
.:data.value->:p->value(等价于
(*p).value)⚠️ B、D 把变量名和成员名写反了;C 用了 -> 但
data 不是指针。
📝
联合体(union)的要点:所有成员共用同一块内存,所以只有最后写入的那个成员是有效的。sizeof(union)
= 最大成员的大小。这跟结构体(每个成员各占各的)是完全不同的。
假设有一个链表的节点定义如下:
struct Node { int data; Node* next; }现在有一个指向链表头部的指针:Node* head。如果想要在链表中插入一个新节点,其成员
data 的值为
,并使新节点成为链表的第一个节点,下面哪个操作是正确的?
A.
Node* newNode = new Node; newNode->data = 42; newNode->next = head; head = newNode;
B.
Node* newNode = new Node; head->data = 42; newNode->next = head; head = newNode;
C.
Node* newNode = new Node; newNode->data = 42; head->next = newNode;
D.
Node* newNode = new Node; newNode->data = 42; newNode->next = head;
答案:A
头插法的三步,顺序不能乱:
Node* newNode = new Node;   // 1. 造新结点
newNode->data = 42;         // 2. 填数据
newNode->next = head;       // 3. 新结点指向原来的头
head = newNode; // 4. 头指针改指向新结点| 选项 | 毛病 |
|---|---|
| B | head->data = 42
改错了对象——把原来的头结点的数据改了 |
| C | 变成了「插在头结点后面」,不是第一个 |
| D | 少了
head = newNode,头指针没更新,新结点等于白接 |
⚠️ D
是最阴的:链表接对了,但没人知道新头在哪,head
还指着老地方。指针题一定要问一句:改完之后,「入口」还对不对?
根节点的高度为 ,一棵拥有 个节点的三叉树高度至少为()。
A. 6 B. 7 C. 8 D. 9
答案:C
高度为 的三叉树最多能装 个结点:
| 高度 | 最多结点 |
|---|---|
| 6 | 364 |
| 7 | 1093 —— 装不下 2023 |
| 8 | 3280 —— 装得下 ★ |
📝 「高度至少为多少」= 把树塞得越满越好,看第几层才够装。 反过来「高度至多为多少」就是排成一条链 = 结点数。
⚠️ 题目特别声明「根节点的高度为 」。如果按「根高为 0」算,答案会差 1,出题人写这句话就是怕你用错约定。每次先找这句话。
小明在某一天中依次有七个空闲时间段,他想要选出至少一个空闲时间段来练习唱歌,但他希望任意两个练习的时间段之间都有至少两个空闲的时间段让他休息。则小明一共有()种选择时间段的方案。
A. 31 B. 18 C. 21 D. 33
答案:B
选中的时段两两之间要隔至少 2 个空闲,也就是相邻两个被选下标之差 。 个时段里穷举:
| 选几个 | 方案数 |
|---|---|
| 1 个 | 7 |
| 2 个 | 10 |
| 3 个 | 1(只有 ) |
| 合计 | 18 |
📝 这类题有个公式:从 个里选 个、相邻间隔 ,方案数是 。这里 : 时 , 时 , 时 。合计 。
⚠️ 「之间有至少两个空闲」= 下标差 ,不是 。 选项 C 的 就是按差 算出来的。把「间隔几个」翻译成「下标差几」时最容易差一,画个格子数一遍。
以下关于高精度运算的说法错误的是()
A. 高精度计算主要是用来处理大整数或需要保留多位小数的运算 B. 大整数除以小整数的处理的步骤可以是,将被除数和除数对齐,从左到右逐位尝试将除数乘以某个数,通过减法得到新的被除数,并累加商 C. 高精度乘法的运算时间只与参与运算的两个整数中长度较长者的位数有关 D. 高精度加法运算的关键在于逐位相加并处理进位
答案:C
C 说「高精度乘法的运算时间只与较长者的位数有关」——错。两个数分别是 位和 位时,竖式乘法要做 次一位乘法,时间取决于两者位数的乘积,。
其余三项都对:A(用途)、B(大整数除法的试商流程)、D(加法逐位相加并进位)。
📝 高精度四则的复杂度背一下:加/减 、乘 、除以单精度 。只有乘法是两者相乘,这就是这题的考点。
后缀表达式 6 2 3 + - 3 8 2 / + * 2 ^ 3 +
对应的中缀表达式是
A. ((6-(2+3))*(3+8/2))^2+3 B. 6-2+3*3+8/2^2+3 C. (6-(2+3))*((3+8/2)^2)+3 D. 6-((2+3)*(3+8/2))^2+3
答案:A
后缀表达式用栈还原:遇数字压栈,遇运算符弹两个、拼起来再压回去。
| 读到 | 栈顶变化 |
|---|---|
6 2 3 |
6, 2, 3 |
+ |
6, (2+3) |
- |
(6-(2+3)) |
3 8 2 |
…, 3, 8, 2 |
/ |
…, 3, (8/2) |
+ |
…, (3+(8/2)) |
* |
((6-(2+3))*(3+(8/2))) |
2 ^ |
(((6-(2+3))*(3+(8/2)))^2) |
3 + |
((((6-(2+3))*(3+(8/2)))^2)+3) |
程序还原结果:((((6-(2+3))*(3+(8/2)))^2)+3),即
A。
📝 后缀转中缀就是「压栈—弹两个—加括号—压回去」,机械照做,别心算。
⚠️
注意弹栈时的先后:先弹出来的是右操作数。写成
(先弹 运算符 后弹) 就全错了——这在减法、除法上立刻暴露。
⚠️ C 的括号位置不同(^2
只套在右半边),别看差不多就选。
数 和 的和为 ( )
A. B. C. D.
答案:D
逐个选项换算:
| 选项 | 十进制 |
|---|---|
| A. | 176 ✗ |
| B. | 158 ✗ |
| C. | 158 ✗ |
| D. | 160 ✓ |
📝 选项进制各不相同时,最快的做法是「全部转成十进制再比」,一个一个换算,别在原进制里绕。
⚠️ B 和 C 都是 ,明显是给算错了 的人准备的两个陷阱。算完之后再复核一遍加法。
假设有一组字符 {a,b,c,d,e,f}, 对应的频率分别为
。请问以下哪个选项是字符abcdef分别对应的一组哈夫曼编码?
A. 1111,1110,101,100,110,0 B.
1010,1001,1000,011,010,00 C.
000,001,010,011,10,11 D.
1010,1011,110,111,00,01
答案:A
频率 构造哈夫曼树,得到的最优码长是:
加权路径长度 (这是理论最优值)。
逐个选项算加权长度:
| 选项 | 码长 | 加权长度 | 是前缀码 |
|---|---|---|---|
| A | 4,4,3,3,3,1 | 224 ✓ 最优 | √ |
| B | 4,4,4,3,3,2 | 281 | √ |
| C | 3,3,3,3,2,2 | 239 | √ |
| D | 4,4,3,3,2,2 | 253 | √ |
📝 不必真去画哈夫曼树再比对编码。 四个选项都是合法前缀码,只要算出各自的加权路径长度,最小的那个就是哈夫曼编码——因为哈夫曼编码的定义就是「加权路径长度最小」。这个思路比构树快得多也不易错。
⚠️ 更快的一步筛法:频率最高的
f(45%)码长必须最短。只有 A 给了它
位,其余都给了
位——一眼就能选出来。
给定一棵二叉树,其前序遍历结果为:ABDECFG,中序遍历结果为:DEBACFG。请问这棵树的正确后序遍历结果是什么?
A. EDBGFCA B. EDGBFCA C.
DEBGFCA D. DBEGFCA
答案:A
前序 ABDECFG、中序 DEBACFG:
A;中序中 A 左边 DEB
是左子树,右边 CFG 是右子树BDE、中序 DEB → 根
B,B 左边是 DE、右边为空DE 前序 DE、中序 DE → 根
D,D 右孩子 ECFG、中序 CFG → 根
C,右边 FG → 根 F,右孩子
G A
/ \
B C
/ \
D F
\ \
E G后序 = EDBGFCA
⚠️ 这棵树是「向一边歪」的,跟 CSP 2024 第 12 题那棵漂亮的满二叉树完全不同。别因为上一年做过就套形状——老老实实按「前序给根、中序分左右」递归。
📝 秒杀技巧:后序最后一个必是根 A。
四个选项结尾都是
A,这招这次不管用;那就改看第一个——后序第一个是「最左下角的叶子」,这里是
E,只有 A、B 符合,再比第二位即可。
考虑一个有向无环图,该图包含 条有向边: 和 。以下哪个选项是这个有向无环图的一个有效的拓扑排序?
A. 4,2,3,1 B. 1,2,3,4 C. 1,2,4,3 D. 2,1,3,4
答案:B
边 要求: 在 、 之前; 在 之前; 在 之前。
| 选项 | 判断 |
|---|---|
A. 4,2,3,1 |
✗ 全反了 |
B. 1,2,3,4 |
✓ |
C. 1,2,4,3 |
✗ 排在 前面,违反 |
D. 2,1,3,4 |
✗ 排在 前面,违反 |
📝 拓扑排序的验法:把每条边 拿出来,检查序列里 是不是排在 前面。 四条边挨个查,比在脑子里模拟入度快。
📝 拓扑排序不唯一——本题 1,3,2,4
也是合法的,只是没出现在选项里。
在计算机中,以下哪个选项描述的数据存储容量最小()
A. 字节 (byte) B. 比特 (bit) C. 字 (word) D. 千字节 (kilobyte)
答案:B
比特是计算机中最小的存储单位(只能存 或 )。
📝 **字(word)**是 CPU 一次能处理的数据宽度,随机器而定(32 位机是 4 字节,64 位机是 8 字节)——它一定 ≥ 1 字节,所以不可能是最小的。
⚠️ 单位换算:,,。是 1024 不是 1000,这在算「多少 bit」的题里差别巨大(参见 CSP 2024 第 5 题)。
一个班级有 个男生和 个女生。如果要选出一个 人的小组,并且小组中必须至少包含 个女生,那么有多少种可能的组合?()
A. B. C. D.
答案:A
用补集:总组合数减去「一个女生都没有」(即全是男生)。
📝 「至少一个 X」几乎永远用补集:总数 − 一个 X 都没有。这比分类讨论(1女/2女/3女)快得多也不容易漏。
⚠️ 选项 C 的 就是 ——「忘了减」。算完补集一定要真的减那一下。
(对比 CSP 2024 第 3 题:那题「每个部门至少一人」有三个组,补集会重叠,就不能用这招,只能枚举分配方案。「至少一个」用补集,「每组至少一个」枚举分配——两句话记清楚。)
以下哪个不是操作系统?()
A. Linux B. Windows C. Android D. HTML
答案:D
HTML 是超文本标记语言(网页的排版语言),不是操作系统。Linux、Windows、Android 都是操作系统。
📝 HTML 严格说也不是「编程语言」,它是标记语言——没有变量、循环、判断。这个区分也考过。
⚠️ 这类送分题唯一的失分方式是看错「不是」两个字。读题时把「不是」「错误的」圈出来。
#include<iostream>
#include<cmath>
using namespace std;

double f(double a,double b,double c){
    double s=(a+b+c)/2;
    return sqrt(s*(s-a)*(s-b)*(s-c));
}
int main(){
   cout.flags(ios::fixed);
   cout.precision(4);

   int a,b,c;
   cin>>a>>b>>c;
   cout<<f(a,b,c)<<endl;
   return 0;
}
假设输入的所有数都为不超过 的正整数,完成下面的判断题和单选题:
(2分)当输入为 2 2 2
时,输出为1.7321( )
(2分)将第7行中的 (s-b)*(s-c) 改为
(s-c)*(s-b) 不会影响程序运行的结果( )
(2分)程序总是输出四位小数( )
当输入为 3 4 5 时,输出为( )
当输入为 5 12 13 时,输出为( )
(1)(2 分)
A. 正确 B. 错误
(2)(2 分)
A. 正确 B. 错误
(3)(2 分)
A. 正确 B. 错误
(4)(3 分)
A. 6.0000 B. 12.0000 C.
24.0000 D. 30.0000
(5)(3 分)
A. 24.0000 B. 30.0000 C.
60.0000 D. 120.0000
答案:(1) A (2) A (3) B (4) A (5) B
海伦公式求三角形面积:,。实测输出:
| 输入 | 输出 |
|---|---|
2 2 2 |
1.7321 |
3 4 5 |
6.0000 |
5 12 13 |
30.0000 |
1 1 5 |
nan ← 关键 |
1 1 2 |
0.0000 |
(1) 正确(A):边长为 的正三角形面积 。实测确认。
(2) 正确(A):把 (s-b)*(s-c) 换成
(s-c)*(s-b) 只是调换乘法顺序。
📝 这里有个很值得记的实测结果:我穷举了
的全部三元组,两种写法的 double 结果有 142190
组在二进制位上不完全相同(浮点乘法的结合顺序会影响舍入),但保留
4
位小数之后,没有任何一组的输出不一样。所以答案是「不影响」。
⚠️ 别把这条推广成「浮点数怎么换顺序都一样」——它们真的不一样,只是这题的精度要求看不出来。
(3) 错误(B):题目只保证输入是「不超过 1000
的正整数」,没保证能构成三角形。输入 1 1 5
时根号里是负数,sqrt 返回 NaN,实测输出
nan——那不是四位小数。
📝 这就是「阅读程序」的标准套路:找题目没排除掉的输入。 题面说「所有数都为不超过 1000 的正整数」,那就去想——它没说是合法三角形。
(4)
6.0000(A):
直角三角形,面积
。
(5)
30.0000(B):
直角三角形,面积
。
#include<iostream>
#include<vector>
#include<algorithm>
using namespace std;

int f(string x,string y){
    int m=x.size();
    int n=y.size();
    vector<vector<int>>v(m+1,vector<int>(n+1,0));
    for(int i=1;i<=m;i++){
       for(int j=1;j<=n;j++){
            if(x[i-1]==y[j-1]){
                v[i][j]=v[i-1][j-1]+1;
            }else{
                v[i][j]=max(v[i-1][j],v[i][j-1]);
            }
        }
    }
    return v[m][n];
}
bool g(string x,string y){
    if(x.size() != y.size()){
        return false;
    }
    return f(x+x,y)==y.size();
}
int main(){
    string x,y;
    cin>>x>>y;
    cout<<g(x,y)<<endl;
    return 0;
}f 函数的返回值小于等于
。()
f
函数的返回值等于两个输入字符串的最长公共子串的长度。()
当输入两个完全相同的字符串时,g 函数的返回值总是
true。()
将第19行中的 v[m][n] 替换为
v[n][m],那么该程序()。
当输入为 csp-j p-jcs 时,输出为()。
当输入为 csppsc spsccp 时,输出为()。
(1)(1.5 分)
A. 正确 B. 错误
(2)(1.5 分)
A. 正确 B. 错误
(3)(1.5 分)
A. 正确 B. 错误
(4)(3 分)
A. 行为不变 B. 只会改变输出 C. 一定非正常退出 D. 可能非正常退出
(5)(3 分)
A. 0 B. 1 C. T D.
F
(6)(3 分)
A. T B. F C. 0 D.
1
答案:(1) A (2) B (3) A (4) D (5) B (6) D
f
是最长公共子序列(LCS);g(x,y)
在长度相同时判断 y 是否为 x+x 的 LCS
全长。实测:
| 输入 | 原程序 | 把 v[m][n] 换成 v[n][m] |
|---|---|---|
csp-j p-jcs |
1 | 0 |
csppsc spsccp |
1 | 0 |
abc abc |
1 | 0 |
abcd dcba |
0 | 0 |
(1) 正确(A):公共子序列最长不可能超过较短那个串的长度。
(2) 错误(B):f
求的是子序列(可以不连续),不是子串(必须连续)。
📝 这一条是整道题的钥匙。 因为 f
求子序列,g 判的其实是「y 是不是
x+x 的子序列」,并不是「y
是不是 x 的循环同构」——第 (6) 小题就是拿这个来考你。
(3) 正确(A):x 与 x
相同时,f(x+x, x) = |x|,返回 true。实测
abc abc 输出 1。
(4) 可能非正常退出(D):v 是
行、每行
列。这里 m = 2|y|、n = |y|,所以
m > n,v[n][m]
的列下标越界了。
⚠️ 实测:字符串长度从 3 一路试到 20000,7
组全部正常退出、输出恒为 0,一次都没崩。
但这恰恰说明答案是 **D「可能」**而不是 C「一定」——vector 的
[]
不查边界,越界读通常只是拿到一个垃圾值,崩不崩看运气。
(5) 1(B):p-jcs 是
csp-j 的循环移位,自然是 csp-jcsp-j
的子序列。实测输出 1。选项 C、D 的
T/F 是干扰——C++ 输出 bool
时打印的是 1/0。
(6) 1(D):实测输出
1。
⚠️ 这题最容易错。 spsccp
并不是 csppsc
的循环移位,但它是 csppsccsppsc
的一个子序列(挑出 s、p、s、c、c、p 即可),而 f
求的就是子序列 —— 所以照样返回
1。如果你按「判断循环同构」去理解这个程序,这一小题必错。
#include <iostream>
#include <cmath>
using namespace std;

int solve1(int n){
    return n*n;
}

int solve2(int n){
   int sum=0;
   for(int i=1;i<=sqrt(n);i++){
        if(n%i==0){
            if(n/i==i){
                sum+=i*i;
            }else{
                sum+=i*i+(n/i)*(n/i);
            }
        }
    }
    return sum;
}
int main(){
    int n;
    cin>>n;
    cout<<solve2(solve1(n))<<" "<<solve1((solve2(n)))<<endl;
    return 0;
}
假设输入的 是绝对值不超过 的整数,完成下面的判断题和单选题。
如果输入的
为正整数,solve2 函数的作用是计算
所有的因子的平方和( )
第 行的作用是避免 的平方根因子 (或 )进入第 行而被计算两次( )
如果输入的
为质数,solve2(n) 的返回值为
(
)
(4分)如果输入的
为质数
的平方,那么 solve2(n) 的返回值为( )
当输入为正整数时,第一项减去第二项的差值一定( )
当输入为 5 时,输出为( )
(1)(1.5 分)
A. 正确 B. 错误
(2)(1.5 分)
A. 正确 B. 错误
(3)(1.5 分)
A. 正确 B. 错误
(4)(4 分)
A. B. C. D.
(5)(3 分)
A. 大于 B. 大于等于 且不一定大于 C. 小于 D. 小于等于 且不一定小于
(6)(3 分)
A. 651 625 B. 650 729 C.
651 676 D. 652 625
答案:(1) A (2) A (3) A (4) B (5) D (6) C
solve1(n) = n²;solve2(n) 枚举到
,成对累加因子的平方,即所有因子的平方和。实测:
| 输入 | 输出(solve2(n²) 和 (solve2(n))²) |
|---|---|
| 1 | 1 1 |
| 2 | 21 25 |
| 3 | 91 100 |
| 4 | 341 441 |
| 5 | 651 676 |
(1) 正确(A):i 与 n/i
成对出现,平方后累加,正是全部因子的平方和。
(2) 正确(A):当 是完全平方数时 ,若不特判就会把这个因子算两次。
(3) 正确(A):质数
只有因子
和
,平方和
。实测
时 solve2(2) = 5 = 1+4 ✓
(4) (B): 的因子是 ,平方和 。而 ,所以 —— 正好相等。实测 (): ✓
⚠️ 选项 D 的 是「先加再平方」,本题是「先平方再加」,差了一个交叉项 。 这两者的区别正是第 (5) 小题的全部内容。
(5) 小于等于 且不一定小于 (D):第一项是 ( 跑遍 的因子),第二项是 ( 跑遍 的因子)。实测 :差值 的有 0 个, 的有 1 个(只有 ), 的有 299 个。
📝 时两项都是 ,差为 ——就因为这一个数,答案从 C(小于 0)变成了 D。 ⚠️ 看到「一定」「总是」,先去试 、 这些边界。
(6)
651 676(C):solve2(25) = 1+25+625 = 651;solve2(5) = 1+25 = 26,26² = 676。实测输出
651 676。
⚠️ 选项 A 的 651 625
只错在第二项(
而不是
)——漏掉了因子
1。四个选项里第一项有三个都是
651,分数全押在第二项上。
#include <iostream>
#include <vector>
using namespace std;
int find_missing(vector<int>& nums) {
    int left = 0, right = nums.size() - 1;
    while (left < right){
        int mid = left + (right - left) / 2;
        if (nums[mid] == mid + ①) {
            ②;
        } else {
            ③;
        }
    }
    return ④;
}
int main() {
    int n;
    cin >> n;
    vector<int> nums(n);
    for (int i = 0; i < n; i++) cin >> nums[i];
    int missing_number = find_missing(nums);
    if (missing_number == ⑤) {
        cout << "Sequence is consecutive" << endl;
    }else{
        cout << "Missing number is " << missing_number << endl;
    }
    return 0;
}(1)(3 分)
A. 1 B. nums[0] C. right D.
left
(2)(3 分)
A. left=mid+1 B. right=mid-1 C.
right=mid D. left=mid
(3)(3 分)
A. left=mid+1 B. right=mid-1 C.
right=mid D. left=mid
(4)(3 分)
A. left+nums[0] B. right+nums[0] C.
mid+nums[0] D. right+1
(5)(3 分)
A. nums[0]+n B. nums[0]+n-1 C.
nums[0]+n+1 D. nums[n-1]
答案:① B ② A ③ C ④ A ⑤ B
在「少了一个数的等差数列」里二分找缺失值。判据:如果
nums[mid] == nums[0] + mid,说明 mid
之前没有断层,缺口在右边。
| 空 | 填 | 为什么 |
|---|---|---|
| ① | nums[0] |
数列不一定从
开始,起点得用 nums[0] |
| ② | left = mid + 1 |
没断层 → 缺口在 mid 右边 |
| ③ | right = mid |
有断层 → 缺口在 mid 或它左边,不能写
mid-1 |
| ④ | left + nums[0] |
收敛点 left 就是缺口的下标 |
| ⑤ | nums[0] + n - 1 |
数列完整时函数会返回最后一个元素的值 |
逐个选项实测(5 / 1 2 3 5 6 应答「缺
4」,4 / 10 11 13 14 应答「缺 12」):
| 改动 | 实测 |
|---|---|
①填 1 |
2 3 4 5 6 误报「缺 2」;10 11 13 14
误报「缺 10」 |
②填 left = mid |
死循环(mid 恒等于
left,范围不缩小) |
③填 right = mid - 1 |
1 2 4 5 6 误报「缺 2」(把正确答案跳过去了) |
⑤填 nums[0] + n |
真正连续的 2 3 4 5 6 被误报成「缺 6」 |
📝 right = mid 和 right = mid - 1
的区别是二分最大的坑。 当判据是「mid
本身可能就是答案」时必须用 right = mid;只有确定
mid 一定不是答案才能
-1。配套地,right = mid 必须搭
while (left < right),否则死循环。
⚠️
顺便记一个这个程序自带的缺陷:如果被移除的恰好是倒数第二个元素(比如
1 2 3 4 6,缺的是 5),函数返回
nums[0]+n-1,正好撞上「连续」的哨兵值,程序会误报
Sequence is consecutive。实测确认。
这不影响选项判断(⑤ 仍然只能填
B),但说明「二分能过样例」不等于「二分写对了」。
#include <iostream>
#include <string>
#include <vector>
using namespace std;
int min(int x, int y, int z) {
    return min(min(x, y), z);
}
int edit_dist_dp(string str1, string str2) {
    int m = str1.length();
    int n = str2.length();
    vector<vector<int>> dp(m + 1, vector<int>(n + 1));
    for (int i = 0; i <= m; i++) {
        for (int j = 0; j <= n; j++) {
            if (i == 0)
                dp[i][j] = ①;
            else if (j == 0)
                dp[i][j] = ②;
            else if (③)
                dp[i][j] = ④;
            else
                dp[i][j] = 1 + min(dp[i][j - 1], dp[i - 1][j], ⑤);
        }
    }
    return dp[m][n];
}
int main() {
    string str1, str2;
    cin >> str1 >> str2;
    cout << "Mininum number of operation:" << edit_dist_dp(str1, str2) << endl;
    return 0;
}(1)(3 分)
A. j B. i C. m D.
n
(2)(3 分)
A. j B. i C. m D.
n
(3)(3 分)
A. str1[i-1]==str2[j-1] B. str1[i]==str2[j]
C. str1[i-1]!=str2[j-1] D.
str1[i]!=str2[j]
(4)(3 分)
A. dp[i-1][j-1]+1 B. dp[i-1][j-1] C.
dp[i-1][j] D. dp[i][j-1]
(5)(3 分)
A. dp[i][j] + 1 B. dp[i-1][j-1]+1 C.
dp[i-1][j-1] D. dp[i][j]
答案:① A ② B ③ A ④ B ⑤ C
编辑距离的经典 DP:dp[i][j] = 把 str1 前
个字符变成 str2 前
个字符的最少操作数。
| 空 | 填 | 含义 |
|---|---|---|
| ① | j |
str1 为空 → 插入
个字符 |
| ② | i |
str2 为空 → 删除
个字符 |
| ③ | str1[i-1] == str2[j-1] |
末尾字符相同(下标要 ,因为 dp 从 1 开始编号) |
| ④ | dp[i-1][j-1] |
相同就不用操作,直接继承 |
| ⑤ | dp[i-1][j-1] |
不同则三选一:插入、删除、替换 |
实测对照(经典结果:sunday→saturday 是
3,kitten→sitting 是 3,intention→execution 是
5):
| 填法 | sunday/saturday | kitten/sitting | intention/execution |
|---|---|---|---|
| 标准答案 | 3 ✓ | 3 ✓ | 5 ✓ |
①填 i |
2 ✗ | 3 | 5 |
③填 str1[i]==str2[j] |
3 | 2 ✗ | 4 ✗ |
④填 dp[i-1][j-1]+1 |
8 ✗ | 7 ✗ | 9 ✗ |
⑤填 dp[i-1][j-1]+1 |
4 ✗ | 5 ✗ | 8 ✗ |
📝 三个转移各对应一种操作,一定要对上号:
| 来源 | 操作 |
|---|---|
dp[i][j-1] |
插入一个字符 |
dp[i-1][j] |
删除一个字符 |
dp[i-1][j-1] |
替换一个字符 |
⚠️ ③ 的下标最容易错。 dp 表的下标从
开始(dp[i][j] 表示前
个),但字符串下标从
开始,所以第
个字符是 str1[i-1]。写成 str1[i]
编译能过、样例可能碰巧也过,但错位一位——实测
kitten/sitting 就从 3 变成 2。
以下哪种功能没有涉及 C++ 语言的面向对象特性支持:( )。
A. C++ 中调用 printf 函数 B. C++
中调用用户定义的类成员函数 C. C++ 中构造一个 class 或
struct D. C++ 中构造来源于同一基类的多个派生类
答案:A
printf 是 C
标准库的函数,跟面向对象没有半点关系。其余三项都是面向对象特性:调用类的成员函数(B)、定义类(C)、继承与派生(D)。
📝 面向对象的三大特征:封装、继承、多态。 初赛只要求认得出来,不要求会写类(那是提高级内容)。
有 个元素,按照 的顺序进入栈 ,请问下列哪个出栈序列是非法的( )。
A. B. C. D.
答案:C
入栈顺序是 。用栈模拟(能弹就弹、不能弹就压):
| 选项 | 判断 |
|---|---|
A. 5,4,3,6,1,2 |
合法 |
B. 4,5,3,1,2,6 |
合法 |
C. 3,4,6,5,2,1 |
非法 |
D. 2,3,4,1,5,6 |
合法 |
C 卡在哪:要先弹 ,就得把 全压进去(栈内自底向上 )。弹 、弹 之后,栈顶是 ,但下一个要弹的是 —— 压在最底下,出不来。
⚠️ 这题的坑是入栈顺序是「递减」的 ,不是常见的 。 一眼扫过去很容易按习惯当成递增。读题时把入栈序列抄到草稿纸上。
📝 判定口诀同 CSP 2024 第 13 题:出栈序列中某个数后面比它小的那些数必须递减。
运行以下代码片段的行为是( )。
int x = 101;
int y = 201;
int *p = &x;
int *q = &y;
p = q;
A. 将 的值赋为 B. 将 的值赋为 C. 将 指向 的地址 D. 将 指向 的地址
答案:D
int *p = &x;   // p 指向 x
int *q = &y;   // q 指向 y
p = q;         // 把 q 的「值」(也就是 y 的地址)赋给 p
p = q
改的是指针本身,不是它指向的内容。执行后 p
和 q 都指向 y,x 和
y 的值一个都没变。
📝 一个字之差要分清:
| 写法 | 改的是谁 |
|---|---|
p = q |
指针:让 p 改指向 q 所指的地方 |
*p = *q |
内容:把 q 指向的值抄给 p 指向的变量(这才会让 变成 201) |
⚠️ A、B 都是把 p = q 误当成 *p = *q
的结果;C 把方向弄反了(是 p 变,不是 q
变)。
链表和数组的区别包括( )。
A. 数组不能排序,链表可以 B. 链表比数组能存储更多的信息 C. 数组大小固定,链表大小可动态调整 D. 以上均正确
答案:C
| 选项 | 判断 |
|---|---|
| A. 数组不能排序,链表可以 | ✗ 说反了,数组更好排 |
| B. 链表比数组能存储更多的信息 | ✗ 链表每个结点还多占了指针的空间 |
| C. 数组大小固定,链表大小可动态调整 | ✓ |
| D. 以上均正确 | ✗ |
📝 数组 vs 链表,两句话概括:
| 数组 | 链表 | |
|---|---|---|
| 按下标随机访问 | 快 | 慢,只能一个个走 |
| 中间插入 / 删除 | 慢,要挪动 | 快,改指针即可 |
| 大小 | 固定 | 动态 |
这张表是链表题的全部考点,正反两面都要能说出来。
对假设栈 和队列 的初始状态为空。存在 六个互不相同的数据,每个数据按照进栈 、出栈 、进队列 、出队列 的顺序操作,不同数据间的操作可能会交错。已知栈 中依次有数据 、、、、 和 进栈,队列 依次有数据 、、、、 和 出队列。则栈 的容量至少是( )个数据。
A. B. C. D.
答案:B
队列是先进先出,所以出队顺序 = 入队顺序 = 出栈顺序 。
按这个出栈顺序模拟(实测逐步):
压1 压2 弹2 压3 压4 弹4 弹3 压5 压6 弹6 弹5 弹1栈内元素最多的时刻是压完 之后(栈内 )——同时最多 3 个。
📝 这题绕在「队列」上,但队列其实是个幌子:先进先出意味着它完全不改变顺序,把它划掉,题目就变成纯粹的「已知出栈序列,求栈最小容量」。
⚠️ 看到多个数据结构串在一起,先找那个「不改变顺序」的(队列),把它约掉。
对表达式 a+(b-c)*d 的前缀表达式为( ),其中 +、-、*
是运算符。
A. *+a-bcd B. +a*-bcd C.
abc-d*+ D. abc-+d
答案:B
a+(b-c)*d 的表达式树:根是 +,左边是
a,右边是 *(* 的左边是
-,右边是 d)。
前缀表达式 = 先根遍历:+ →
a → * → - → b →
c → d,即
+a*-bcd。
📝 三种表达式对应三种遍历:
| 表达式 | 遍历方式 | 结果 |
|---|---|---|
| 前缀(波兰式) | 先根 | +a*-bcd |
| 中缀 | 中根 | a+(b-c)*d |
| 后缀(逆波兰式) | 后根 | abc-d*+ |
⚠️ 选项 C 的 abc-d*+
是后缀表达式,看错「前缀/后缀」就直接错了。读题先圈「前」还是「后」。
假设字母表 在字符串出现的频率分别为 ,,,,。若使用哈夫曼编码方式对字母进行不定长的二进制编码,字母 的编码长度( )位。
A. B. C. 或 D.
答案:B
频率 ,哈夫曼合并过程(实测):
| 步 | 合并 | 新权 |
|---|---|---|
| 1 | 25 | |
| 2 | 41 | |
| 3 | 59 | |
| 4 | 100 |
得到码长:。
⚠️ 注意第 2 步:(16)和刚合出来的 25 合并, 只往下走了两层。 很多人会以为 排在中间就一定是 3 位——必须真的按「每次取最小的两个」做一遍。
📝 选项 C 写的是「2 或 3」,专门给「感觉不确定」的人准备。哈夫曼树的形状虽然可能不唯一(权值相等时),但每个字符的码长是确定的。
一棵有 个结点的完全二叉树用数组进行存储与表示,已知根结点存储在数组的第 个位置。若存储在数组第 个位置的结点存在兄弟结点和两个子结点,则它的兄弟结点和右子结点的位置分别是( )。
A. 、 B. 、 C. 、 D. 、
答案:C
完全二叉树用数组存(根在下标 1)时的三个公式:
对 :
所以是 、。
📝 兄弟结点的判法:编号是偶数就跟右边那个()是兄弟,是奇数就跟左边那个()是兄弟。
⚠️ 四个选项就是 的四种组合——两个都得算对才能得分,任何一个想当然都会落到干扰项上。
考虑由 个顶点构成的有向连通图,采用邻接矩阵的数据结构表示时,该矩阵中至少存在( )个非零元素。
A. B. C. D.
答案:B
有向连通(强连通)图要求任意两点互相可达。最省的连法是把 个点串成一个有向环 ,恰好 条边。
邻接矩阵里一条边对应一个非零元素,所以至少 个。
📝 少于 条边一定不行: 个点如果只有 条边,必然存在某个点出度为 (或入度为 ),从它就出不去(或进不来)。
⚠️ 对照记:无向连通图最少需要 条边(一棵树)。有向的要多一条,因为得绕回来。选项 A 的 就是拿无向的结论来套。
以下对数据结构的表述不恰当的一项为:( )。
A. 图的深度优先遍历算法常使用的数据结构为栈。 B. 栈的访问原则后进先出,队列的访问原则是先进先出。 C. 队列常常被用于广度优先搜索算法。 D. 栈与队列存在本质不同,无法用栈实现队列。
答案:D
D 说「栈与队列存在本质不同,无法用栈实现队列」——错。用两个栈就能实现一个队列:一个负责进、一个负责出,出栈空了就把进栈的元素全倒过去。(反过来,用两个队列也能实现栈。)
其余三项都对:DFS 用栈(A)、后进先出 / 先进先出(B)、BFS 用队列(C)。
📝 「两个栈实现队列」是很经典的一个结论,记住结论即可,初赛不要求你写出来。
⚠️ 这题问的是「不恰当的一项」。「不」字圈出来。
以下哪组操作能完成在双向循环链表结点
之后插入结点
的效果(其中,next 域为结点的直接后继,prev
域为结点的直接前驱):( )。
A.
p->next->prev=s; s->prev=p; p->next=s; s->next=p->next;
B.
p->next->prev=s; p->next=s; s->prev=p; s->next=p->next;
C.
s->prev=p; s->next=p->next; p->next=s; p->next->prev=s;
D.
s->next=p->next; p->next->prev=s; s->prev=p; p->next=s;
答案:D
在双向循环链表结点 p 之后插入
s,涉及四条指针。关键是:一旦改了
p->next,就再也找不到原来的后继了。所以必须先把
p->next 用完,最后才改它。
正确顺序(D):
s->next = p->next;       // 1. 先记住原后继
p->next->prev = s;       // 2. 原后继的 prev 指向 s(此时 p->next 还是原后继)
s->prev = p;             // 3. s 的前驱是 p
p->next = s; // 4. 最后才改 p->next| 选项 | 毛病 |
|---|---|
| A | 先做了 p->next = s,最后
s->next = p->next 变成
s->next = s,自环 |
| B | 同上,s->next 也指向了自己 |
| C | 先 p->next = s 再
p->next->prev = s,把 s->prev
覆盖成了 s 自己 |
📝 链表指针题的通用查法:把「还需要用到旧值」的那条指针放到最后改。 拿不准就在草稿纸上画四个箭头,一条一条划掉。
以下排序算法的常见实现中,哪个选项的说法是错误的:( )。
A. 冒泡排序算法是稳定的 B. 简单选择排序是稳定的 C. 简单插入排序是稳定的 D. 归并排序算法是稳定的
答案:B
简单选择排序是不稳定的。
反例:{5a, 5b, 3}(两个 5 用下标区分)。第一轮选出最小的
3,与位置 1 的 5a 交换 → {3, 5b, 5a},两个 5
的相对顺序被交换了。
📝 稳定性一张表背下来(初赛年年考):
| 排序 | 稳定? |
|---|---|
| 冒泡排序 | ✓ 稳定 |
| 简单选择排序 | ✗ 不稳定 |
| 直接插入排序 | ✓ 稳定 |
| 归并排序 | ✓ 稳定 |
| 快速排序 | ✗ 不稳定 |
| 堆排序 | ✗ 不稳定 |
| 计数排序 / 基数排序 | ✓ 稳定 |
⚠️ 口诀:「快、选、堆」不稳定,其余都稳定。 三个字记住就行。
(这一条在复赛也有用——见
S2_排序的稳定性与原下标技巧.md。)
八进制数 对应的十进制数是( )。
A. B. C. D.
答案:C
小数点左边按 ,右边按 :
📝 带小数的进制转换,小数点右边的权是 ,跟左边是对称的。二进制的 、。
⚠️ 选项 A、B 的整数部分 是「把 当成 忘了加 」;选项 D 的 是把 算成了 。四个选项刚好覆盖了两处独立的错误。
一个字符串中任意个连续的字符组成的子序列称为该字符串的子串,则字符串 有( )个内容互不相同的子串。
A. B. C. D.
答案:A
abcab 长度为
,全部子串共
个,去重后剩 12 个(实测枚举):
长度1: a  b  c              (ab 各出现两次)
长度2: ab bc ca             (ab 出现两次)
长度3: abc bca cab
长度4: abca bcab
长度5: abcab⚠️ 重复的是 a、b、ab
这三个(分别出现在开头和结尾):。
📝 题干说的是「任意个连续的字符」= 子串(连续),不是子序列(可不连续)。 这两个词在初赛里反复被拿来做文章(CSP 2023 第 17 题也考了同一对概念)。看到就停一下,确认是哪一个。
以下对递归方法的描述中,正确的是:( )。
A. 递归是允许使用多组参数调用函数的编程技术 B. 递归是通过调用自身来求解问题的编程技术 C. 递归是面向对象和数据而不是功能和逻辑的编程语言模型 D. 递归是将用某种高级语言转换为机器代码的编程技术
答案:B
递归 = 函数直接或间接调用自身来求解问题。
⚠️ 其余三项都是别的东西:C 描述的是面向对象,D 描述的是编译器,A 是瞎编的。
📝 递归的两个必备零件:① 递归出口(边界条件)② 每次调用规模都要变小。少一个就是死循环——CSP 2024 第 20 题(汉诺塔)的 ⑤ 填错就是活例子。
01 #include <iostream>
02
03 using namespace std;
04
05 int main()
06 {
07     unsigned short x, y;
08     cin >> x >> y;
09     x = (x | x << 2)& 0x33;
10     x = (x | x << 1)& 0x55;
11     y = (y | y << 2)& 0x33;
12     y = (y | y << 1)& 0x55;
13     unsigned short z = x | y << 1;
14     cout << z << endl;
15     return 0;
16 }
假设输入的 均是不超过 的自然数,完成下面的判断题和单选题:
判断题
2 2 时,输出为 10。2 2 时,输出为 59。单选题
13 8 时,输出为( )。(1)(1.5 分)
A. 正确 B. 错误
(2)(1.5 分)
A. 正确 B. 错误
(3)(1.5 分)
A. 正确 B. 错误
(4)(1.5 分)
A. 正确 B. 错误
(5)(1.5 分)
A. 正确 B. 错误
(6)(3 分)
A. B. C. D.
答案:(1) A (2) B (3) B (4) B (5) B (6) B
这段代码在做位交错(Morton 码):把 x
的 4 个二进制位摊到偶数位、y
的摊到奇数位,再合起来。实测输出:
| 输入 | unsigned short(原程序) |
去掉 unsigned |
改成 char |
|---|---|---|---|
2 2 |
12 | 12 | 乱码字符 |
13 8 |
209 | 209 | 乱码字符 |
0 0 |
0 | 0 | 乱码字符 |
15 15 |
255 | 255 | 乱码字符 |
(1) 正确(A):输入不超过 15,中间结果最大也才
,远没到
short 的符号位,去掉 unsigned
输出完全相同(实测 5 组逐一对上)。
(2) 错误(B):char 虽然也够装
(unsigned char),但
cout << 一个 char
打印的是「字符」不是「数字」——实测输出的是乱码,不是
12。
📝 这就是 char
最大的坑:它在算术上是整数,在输出上是字符。 要按数字打印必须写
cout << (int)c。
(3) 错误(B):输入 2 2 时输出
12,不是 0。
(4) 错误(B)、(5) 错误(B):输入
2 2 实测输出是 12——既不是
也不是
。两小题都是错的,别以为「二选一必有一对」。
(6)
209(B):
摊到偶数位得
;
摊到奇数位得
;合起来
。实测确认。
📝 (x | x << 2) & 0x33
这一串看着吓人,其实是固定套路——「把低 4 位摊开成隔一位一个」。
考场上不用看懂原理,直接手动模拟位运算:写出二进制,移位、或、与,三步算完。
1  #include <algorithm>
2  #include <iostream>
3  #include <limits>
4
5  using namespace std;
6
7  const int MAXN = 105;
8  const int MAXK = 105;
9
10 int h[MAXN][MAXK];
11
12 int f(int n, int m)
13 {
14     if (m == 1) return n;
15     if (n == 0) return 0;
16
17     int ret = numeric_limits<int>::max();
18     for (int i = 1; i <= n; i++)
19         ret = min(ret, max(f(n - i,m), f(i - 1, m - 1)) + 1);
20     return ret;
21 }
22
23 int g(int n, int m)
24 {
25     for (int i = 1;i <= n; i++)
26         h[i][1]= i;
27     for (int j = 1;j<= m; j++)
28         h[0][j]= 0;
29
30     for (int i= 1; i <= n; i++){
31         for (int j= 2; j <= m; j++){
32             h[i][j] = numeric_limits<int>::max();
33             for (int k = 1;k <= i;k++)
34             h[i][j]= min(
35                 h[i][j],
36                 max(h[i - k][j],h[k - 1][j - 1]) +1);
37         }
38     }
39
40     return h[n][m];
41 }
42
43 int main()
44 {
45     int n,m;
46     cin >> n>> m;
47     cout << f(n, m) << endl << g(n, m)<< endl;
48     return 0;
49 }
假设输入的n、m均是不超过100 的正整数,完成下面的判断题和单选题:
判断题
7 3 时,第
行用来取最小值的 min 函数执行了
次。单选题
20 2 时,输出的第一行为( )。100 100 时,输出的第一行为( )。(1)(1.5 分)
A. 正确 B. 错误
(2)(1.5 分)
A. 正确 B. 错误
(3)(1.5 分)
A. 正确 B. 错误
(4)(3 分)
A. B. C. D.
(5)(3 分)
A. B. C. D.
(6)(4 分)
A. B. C. D.
答案:(1) B (2) A (3) A (4) C (5) C (6) B
经典的扔鸡蛋问题:f
是朴素递归,g 是同一个递推的 DP 版本。实测:
| 输入 | f 的结果 |
g 的结果 |
第 19 行 min 调用次数 |
|---|---|---|---|
7 3 |
3 | 3 | 448 |
20 2 |
6 | 6 | 1048575 |
10 2 |
4 | 4 | 1023 |
8 1 |
8 | 8 | 0 |
100 100 |
(跑不完) | 7 | — |
(1) 错误(B):实测是 448 次,不是 449 次。
(2) 正确(A):f 和 g
是同一个递推式的两种写法(一个递归、一个填表),实测五组全部两行相同。
(3) 正确(A):f 第一句就是
if (m == 1) return n;。实测 8 1 输出
8。
(4)
(C):g
是三重循环——外层
跑
次、中层
跑
次、内层
跑到
(平均
),合起来
。
📝 数循环层数是初赛复杂度题最可靠的办法:内层跑到 就按 算,别管常数。
(5)
6(C):
层楼
个鸡蛋,最优策略最坏需要
次。实测确认。
(6) 7(B):鸡蛋足够多(100
个)时就是二分查找,。
⚠️ 注意:f(100, 100)
这个朴素递归没有记忆化,实际根本跑不出来(20 2
就已经调用了一百多万次
min)。这一小题要靠「两行输出总是相同」(判断题
2)绕过去——用 g(100,100) 的值回答。 实测
g(100,100) = 7。
📝 这是一个很有用的考场技巧:前面的判断题往往是后面单选题的钥匙。 做阅读程序时,做完判断题先别急着翻页,想想它们能不能用来算后面的。
1  #include <iostream>
2
3  using namespace std;
4
5  int n,k;
6
7  int solve1()
8  {
9      int l = 0, r = n;
10     while(l <= r){
11         int mid = (l + r) / 2;
12         if (mid * mid <= n) l = mid + 1;
13         else r = mid - 1;
14     }
15     return l - 1;
16 }
17
18 double solve2(double x)
19 {
20         if (x == 0) return x;
21         for (int i = 0; i < k; i++)
22             x = (x + n / x) / 2;
23     return x;
24 }
25
26 int main()
27 {
28     cin >> n >> k;
29     double ans = solve2(solve1());
30     cout << ans << ' ' << (ans * ans == n) << endl;
31     return 0;
32 }
假设 int 为32位有符号整数类型,输入的 n 是不超过47000的自然数、k 是不超过 int 表示范围的自然数,完成下面的判断题和单选题:
判断题
9801 1 时,输出的第一个数为
99。mid 强制转换为
位整数再计算。单选题
2 1 时,输出的第一个数最接近( )。3 10 时,输出的第一个数最接近( )。256 11 时,输出的第一个数( )。(1)(1.5 分)
A. 正确 B. 错误
(2)(1.5 分)
A. 正确 B. 错误
(3)(1.5 分)
A. 正确 B. 错误
(4)(1.5 分)
A. 正确 B. 错误
(5)(3 分)
A. B. C. D.
(6)(3 分)
A. B. C. D.
(7)(3 分)
A. 等于 B. 接近但小于 C. 接近但大于 D. 前三种情况都有可能
答案:(1) A (2) A (3) B (4) B (5) C (6) B (7) A
solve1 用二分求
,solve2
用牛顿迭代法迭代
次逼近
。实测:
| 输入 | 输出 |
|---|---|
9801 1 |
99 1 |
2 1 |
1.5 0 |
3 10 |
1.732050808 0 |
256 11 |
16 1 |
2 50 |
1.414213562 0 |
3 1000000 |
1.732050808 0 |
(1) 正确(A):solve1 是二分
,solve2
是
次循环
,合起来
。
(2)
正确(A):,solve1
返回
;牛顿迭代
原地不动。实测 99。
(3) 错误(B):第二个数是
ans * ans == n
这个浮点数精确相等判断。
不是完全平方数时,
是无理数,再迭代多少次都不可能精确相等——实测
2 50 和 3 1000000 的第二个数都是
0。
⚠️ 浮点数不能用 ==
比较,这是竞赛第一大坑。要比较得写
fabs(a-b) < 1e-9。
(4) 错误(B):题目限定
。实测穷举
的全部二分过程,出现过的最大 mid*mid 是
,离
int 上限
还差得远——不会溢出,所以「有缺陷、应当强转 64
位」这句话是错的。
📝 为什么 mid 到不了
:第一次
mid = n/2 = 23500,
已经远大于
,于是
r 立刻缩小。二分的 mid
根本没机会取到接近
的值。
⚠️ 但这个「防溢出」的直觉本身是对的——如果
能取到
,mid*mid
就真的会溢出。这题只是恰好被数据范围救了。考场上遇到
mid*mid,第一反应仍然应该是「会不会溢出」,然后去查数据范围。
(5)
1.5(C):solve1(2) = 1,迭代一次
。实测确认。
(6) 1.732(B):迭代 10 次已经收敛到
。实测
1.732050808。
(7) 等于
(A):solve1(256) = 16,而
已经是精确解,
原地不动,迭代多少次都是
。实测输出
16 1(第二个数是 1,说明确实精确相等)。
试补全枚举程序。
#include <bits/stdc++.h>
using namespace std;

int main(){
    int n;
    cin >> n;

    vector<int> fac;
    fac.reserve((int)ceil(sqrt(n)));

    int i;
    for (i = 1; i * i < n; ++i){
        if (①){
            fac.push_back(i);
        }
    }

    for (int k = 0; k < fac.size(); ++k){
        cout << ② << "";
    }
    if (③) {
        cout << ④ << "";
    }
    for (int k = fac.size() - 1; k >= 0; --k){
        cout << ⑤ << "";
    }
}
①~⑤处应填( )
(1)(3 分)
A. n % i == 0 B. n % i == 1 C.
n % (i-1) == 0 D. n % (i-1) == 1
(2)(3 分)
A. n / fac[k] B. fac[k] C.
fac[k]-1 D. n / (fac[k]-1)
(3)(3 分)
A. (i-1)*(i-1)== n B. (i-1)*i == n C.
i*i == n D. i*(i-1) == n
(4)(3 分)
A. n-i B. n-i+1 C. i-1 D.
i
(5)(3 分)
A. n / fac[k] B. fac[k] C.
fac[k]-1 D. n / (fac[k]-1)
答案:① A ② B ③ C ④ D ⑤ A
从小到大打印
的所有因数。思路:只枚举到
,把小因数存进
fac;先正序打印小因数,中间处理完全平方数的情形,再倒序打印对应的大因数
。
| 空 | 填 | 为什么 |
|---|---|---|
| ① | n % i == 0 |
整除才是因数 |
| ② | fac[k] |
正序打印小因数 |
| ③ | i * i == n |
循环条件是 i*i < n,退出时若 i*i == n
说明
是完全平方数 |
| ④ | i |
补上正中间那个因数 |
| ⑤ | n / fac[k] |
倒序打印大因数 |
逐个选项实测(输入 36 应输出
1 2 3 4 6 9 12 18 36):
| 改动 | 实测输出(n = 36) |
死在哪 |
|---|---|---|
| 标准答案 | 1 2 3 4 6 9 12 18 36 ✓ |
|
③填 (i-1)*(i-1)==n |
1 2 3 4 9 12 18 36 |
漏掉正中间的 6 |
④填 i-1 |
1 2 3 4 5 9 12 18 36 |
中间那个变成 5 |
⑤填 fac[k] |
1 2 3 4 6 4 3 2 1 |
后半段成了镜像,不是大因数 |
📝 枚举因数只跑到 是必背套路(复杂度从 降到 )。成对出现:找到 就同时得到 。
⚠️ 完全平方数必须特判,否则
这个因数会被算两次或者漏掉——注意本题循环条件是
i * i < n(严格小于),所以
根本没进 fac,得靠 ③④ 补。这跟 CSP 2023 第 18 题里
if (n/i == i) 的特判是同一件事的两种写法。
现有用字符标记像素颜色的 图像。颜色填充的操作描述如下:给定起始像素的位置待填充的颜色,将起始像素和所有可达的像素(可达的定义:经过一次或多次的向上、下、左、右四个方向移动所能到达且终点和路径上所有像素的颜色都与起始像素颜色相同),替换为给定的颜色。
试补全程序。
#include<bits/stdc++.h>
using namespace std;

const int ROWS = 8;
const int COLS = 8;

struct Point {
    int r, c;
    Point(int r, int c): r(r), c(c) {}
};

bool is_valid(char image[ROWS][COLS], Point pt,
              int prev_color, int new_color) {
    int r = pt.r;
    int c = pt.c;
    return (0 <= r && r < ROWS && 0 <= c && c < COLS &&
            ① && image[r][c] != new_color);
}

void flood_fill(char image[ROWS][COLS], Point cur, int new_color) {
    queue<Point> queue;
    queue.push(cur);

    int prev_color = image[cur.r][cur.c];
    ②;

    while (!queue.empty()) {
        Point pt = queue.front ();
        queue.pop ();

        Point points[4] = {③, Point(pt.r - 1, pt.c),
                           Point(pt.r, pt.c + 1), Point(pt.r, pt.c - 1)};
        for (auto p : points) {
            if (is_valid(image, p, prev_color, new_color)) {
                ④;
                ⑤;
            }
        }
    }
}

int main() {
    char image[ROWS][COLS] = {{'g', 'g', 'g', 'g', 'g', 'g', 'g', 'g'},
                              {'g', 'g', 'g', 'g', 'g', 'g', 'r', 'r'},
                              {'g', 'r', 'r', 'g', 'g', 'r', 'g', 'g'},
                              {'g', 'b', 'b', 'b', 'b', 'r', 'g', 'r'},
                              {'g', 'g', 'g', 'b', 'b', 'r', 'g', 'r'},
                              {'g', 'g', 'g', 'b', 'b', 'b', 'b', 'r'},
                              {'g', 'g', 'g', 'g', 'g', 'b', 'g', 'g'},
                              {'g', 'g', 'g', 'g', 'g', 'b', 'b', 'g'}};

    Point cur(4, 4);
    char new_color = 'y';

    flood_fill(image, cur, new_color);

    for (int r = 0; r < ROWS; r++) {
        for (int c = 0; c < COLS; c++) {
            cout << image[r][c] << '';
        }
        cout << endl;
    }
//输出:
// g g g g g g g g
// g g g g g g r r
// g r r g g r g g
// g y y y y r g r
// g g g y y r g r
// g g g y y y y r
// g g g g g y g g
// g g g g g y y g

    return 0;
}
①~⑤处应填( )
(1)(3 分)
A. image[r][c] == prev_color B.
image[r][c] != prev_color C.
image[r][c] == new_color D.
image[r][c] != new_color
(2)(3 分)
A. image[cur.r+1][cur.c] = new_color B.
image[cur.r][cur.c] = new_color C.
image[cur.r][cur.c+1] = new_color D.
image[cur.r][cur.c] = prev_color
(3)(3 分)
A. Point(pt.r, pt.c) B. Point(pt.r, pt.c+1)
C. Point(pt.r+1, pt.c) D.
Point(pt.r+1, pt.c+1)
(4)(3 分)
A. prev_color = image[p.r][p.c] B.
new_color = image[p.r][p.c] C.
image[p.r][p.c] = prev_color D.
image[p.r][p.c] = new_color
(5)(3 分)
A. queue.push(p) B. queue. push (pt) C.
queue.push(cur) D.
queue. push(Point (ROWS, COLS))
答案:① A ② B ③ C ④ D ⑤ A
用 BFS 做洪水填充(Flood Fill)。
| 空 | 填 | 为什么 |
|---|---|---|
| ① | image[r][c] == prev_color |
只填「和起点同色」的格子 |
| ② | image[cur.r][cur.c] = new_color |
起点自己也要染色 |
| ③ | Point(pt.r + 1, pt.c) |
四个方向里缺的那个「下」 |
| ④ | image[p.r][p.c] = new_color |
入队前就染色(关键) |
| ⑤ | queue.push(p) |
把邻居入队 |
实测:标准答案跑出来的 结果与题面注释里给的期望输出逐字一致。
| 改动 | 实测 |
|---|---|
③填 Point(pt.r, pt.c) |
只填了上半块,下面三行的 b 一个没变 |
⑤填 queue.push(pt) |
图案填得七零八落 |
⚠️ ② 有个必须说清楚的地方:填
D(= prev_color,等于什么都没做)在这道题给的图上跑出来的结果和标准答案一模一样——因为起点
的邻居会反过来把它染上色。
但换一张图就露馅:起点是个四周都不同色的孤立像素时,实测——
②填 B(正确)      ②填 D(错误)
g g g              g g g
g y g              g b g     ← 起点没被染色
g g g              g g g
📝 这是「实测过了不等于写对了」的又一个例子。 完善程序题里,用题目自带的那组数据验证是不够的,要自己想一组能把区别逼出来的数据。
📝 ④
为什么必须「入队前染色」:如果等出队时再染,同一个格子可能被多个邻居重复入队,队列会爆炸(严重时死循环)。BFS
的铁律:入队即标记。 这条在复赛的 BFS 题里同样是保命规则(见
L07_广度优先搜索与队列.md)。
以下不属于面向对象程序设计语言的是( )。
A. C++ B. Python C. Java D. C
答案:D
C 语言是面向过程的,没有类、继承、多态。C++、Python、Java 都支持面向对象。
📝 C 和 C++ 是两种语言,C++ 在 C 的基础上加了面向对象等特性。竞赛里写的「C++」大部分时候其实只用到了 C 的那部分 + STL。
以下奖项与计算机领域最相关的是( )。
A. 奥斯卡奖 B. 图灵奖 C. 诺贝尔奖 D. 普利策奖
答案:B
图灵奖(Turing Award)由 ACM 颁发,被称为「计算机界的诺贝尔奖」。奥斯卡是电影,诺贝尔没有计算机奖项,普利策是新闻。
📝 初赛常识题里的几个名字:图灵(图灵机、图灵测试、图灵奖)、冯·诺依曼(存储程序原理、冯·诺依曼体系结构)、香农(信息论)。中国的姚期智是首位获图灵奖的华人。
目前主流的计算机储存数据最终都是转换成( )数据进行储存。
A. 二进制 B. 十进制 C. 八进制 D. 十六进制
答案:A
计算机内部最终都用二进制存储(只有高低电平两种状态)。八进制、十六进制只是给人看的简写。
📝 十六进制流行是因为一位十六进制正好对应四位二进制,转换不用算。
以比较作为基本运算,在 个数中找出最大数,最坏情况下所需要的最少的比较次数为 ( )。
A. B. C. D.
答案:C
个数打擂台找最大值:擂主先取第一个,剩下 个各比一次,共 次。
📝 这是理论下界,不可能更少——每次比较最多淘汰一个候选,要淘汰 个就至少比 次。
⚠️ 但「同时找最大和最小」的下界是 (两两配对先比),不是 。这个结论也考过。
对于入栈顺序为 的序列,下列( )不是合法的出栈序列。
A. B. C. D.
答案:D
入栈顺序 。用栈模拟(实测):
| 选项 | 判断 |
|---|---|
A. a,b,c,d,e |
合法(进一个出一个) |
B. e,d,c,b,a |
合法(全进再全出) |
C. b,a,c,d,e |
合法 |
D. c,d,a,e,b |
非法 |
D 卡在哪:弹 (栈内 )→ 压 弹 → 下一个要弹 ,但栈顶是 , 在它下面出不来。
📝 口诀(三年三考):出栈序列中,某个数后面比它小的那些数必须递减。 D 里 后面跟着 —— 比 小却排在后面,违规。
对于有 个顶点、 条边的无向连通图 ,需要删掉( )条边才能使其成为一棵树。
A. B. C. D.
答案:D
个顶点的树恰好有 条边。原图有 条边,要删掉:
⚠️ 别把 漏掉。选项 B 的 就是漏了这一步——四个选项就是围着这个 转。
📝 顺带记:这个数 也叫图的圈秩,等于图中独立回路的个数。
二进制数 对应的十进制数是( )。
A. 6.5 B. 5.5 C. 5.75 D. 5.25
答案:C
📝 二进制小数点右边的权:,,。这三个背下来,二进制小数题基本都能秒。
⚠️ 选项 D 的 是把 当成了 ;A 的 是整数部分算错。
如果一棵二叉树只有根结点,那么这棵二叉树高度为 。请问高度为 的完全二叉树有 ( )种不同的形态?
A. 16 B. 15 C. 17 D. 32
答案:A
高度为 的完全二叉树,结点数只能是 到 (第 层至少放 个、至多放满 个)。
完全二叉树的形状由结点数唯一确定(必须从左往右连续填),所以有
📝 关键认识:完全二叉树「结点数 ⇄ 形状」是一一对应的。 想通这一点,题目就变成简单的数数。
⚠️ 选项 D 的 是「第 5 层每个位置放不放各 2 种」的错误算法——完全二叉树不允许中间留空。
表达式 的后缀表达式为( ),其中 和 是运算符。
A. B. C. D.
答案:B
a*(b+c)*d 的表达式树:* 左边是
a*(b+c),右边是 d。
后缀(后根遍历):先
a、b、c、+(得
b+c)、*(得
a*(b+c))、d、* →
abc+*d*
📝 验证技巧:后缀表达式里运算符的顺序 =
实际计算的先后顺序。 这里先算 +、再算第一个
*、最后算第二个 *——和括号要求一致 ✓
⚠️ 选项 C 的 abc+d** 把两个 *
挤在一起,意思变成
a*((b+c)*d)。虽然乘法有结合律、结果相同,但作为「表达式树的后缀遍历」它对应的是另一棵树,不是本题的树。A、D
是前缀写法,直接排除。
个人,两个人组一队,总共组成三队,不区分队伍的编号。不同的组队情况有( )种。
A. 10 B. 15 C. 30 D. 20
答案:B
人两两组队成 队、队伍不编号:
📝 另一种数法(更不容易错):固定第 1 个人,他有 种选队友;剩下 人里固定一个,有 种;最后 人自动成队。 ✓
⚠️ 选项 C 的 就是「忘了除以 」——只要题目说「不区分队伍」,就必须再除以队数的阶乘。
在数据压缩编码中的哈夫曼编码方法,在本质上是一种( )的策略。
A. 枚举 B. 贪心 C. 递归 D. 动态规划
答案:B
哈夫曼编码每一步都「取当前最小的两个权值合并」——只看眼前最优,不回头,这是贪心的典型特征。
📝 四个词的分辨:
| 策略 | 特征 |
|---|---|
| 枚举 | 把所有可能都试一遍 |
| 贪心 | 每步取当前最优,不反悔 |
| 递归 | 函数调用自身 |
| 动态规划 | 记录子问题的解,避免重复计算 |
⚠️ 哈夫曼树的构造过程是贪心;但「求最优前缀码」这个问题本身也可以用 DP 做。题目问的是「本质上是一种什么策略」,指的是这个算法。
由 这五个数字组成不同的三位数有( )种。
A. 18 B. 15 C. 12 D. 24
答案:A
用 里的数字组三位数,程序穷举去重后得 18 种:
112 113 121 122 123 131 132 211 212
213 221 223 231 232 311 312 321 322
📝 手算思路:按数字组成分类
| 组成 | 排列数 |
|---|---|
| 两个相同 + 一个不同(如 1,1,2) | 种组成 |
| 三个都不同(1,2,3) | |
| 合计 18 |
(「两个相同 + 一个不同」的 4
种:112型、113型、221型、223型。)
⚠️ 不能直接用 之类的整体公式——只取 3 个而不是全排,必须分类。
考虑如下递归算法
solve(n)
     if n<=1 return 1
      else if n>=5 return n*solve(n-2)
      else return n*solve(n-1)
则调用 solve(7) 得到的返回结果为( )。
A. 105 B. 840 C. 210 D. 420
答案:C
solve(n) = 1                 若 n ≤ 1
         = n * solve(n-2)    若 n ≥ 5
         = n * solve(n-1)    其余(2 ≤ n ≤ 4)
从小往大填表:
| 1 | 2 | 3 | 4 | 5 | 6 | 7 | |
|---|---|---|---|---|---|---|---|
solve(n) |
1 | 2 | 6 | 24 | 30 | 144 | 210 |
solve(5) = 5 × solve(3) = 5 × 6 = 30(
走减 2 的分支)solve(7) = 7 × solve(5) = 7 × 30 = 210⚠️ 注意 solve(5) 走的是「减
2」那条分支(因为
),跳过了
。选项
B 的 $840 = 7 \times 5 \times 4! $ 就是错走了「减
1」。分支条件的先后顺序决定一切,读的时候按代码顺序逐条判。
以
为起点,对下边的无向图进行深度优先遍历,则
四个点中有可能作为最后一个遍历到的点的个数为( )。
A. 1 B. 2 C. 3 D. 4
答案:B
图中的边:、、、、。
程序穷举了每个顶点邻居顺序的所有排列,从 出发一共只有 3 种不同的 DFS 序:
a b d c e     ← 最后是 e
a c d b e     ← 最后是 e
a c e d b     ← 最后是 b
所以能当「最后一个」的只有 和 ,共 2 个。
📝 DFS 的最后一个点必须是「走到头出不去」的那个。 和 都夹在环里(),无论怎么走,它们后面总还有没访问过的邻居,不可能收尾。
⚠️ 这题千万别只试一两种走法就下结论。 手工枚举时按「从 先走 」和「从 先走 」两大分支展开,每支再分,很快就能穷尽。
有四个人要从 A 点坐一条船过河到 B 点,船一开始在 A 点。该船一次最多可坐两个人。 已知这四个人中每个人独自坐船的过河时间分别为 ,且两个人坐船的过河时间为两人独自过河时间的较大者。则最短( )时间可以让四个人都过河到 B 点(包括从 B 点把船开回 A 点的时间)。
A. 14 B. 15 C. 16 D. 17
答案:B
经典过桥问题,四人耗时 。程序搜索全部方案,最短是 15:
| 步 | 动作 | 耗时 | 累计 |
|---|---|---|---|
| 1 | 一起过去 | 2 | 2 |
| 2 | 把船开回来 | 1 | 3 |
| 3 | 一起过去 | 8 | 11 |
| 4 | 把船开回来 | 2 | 13 |
| 5 | 一起过去 | 2 | 15 |
📝 核心思想:让两个最慢的人「搭伴同行」,这样 那一趟顺便把 也带过去了, 的时间被 完全吸收。
⚠️ 直觉上「让最快的人一直当船夫」( 每次都陪着过、再开回来)反而更慢:,正好是选项 C。这题就是专门考这个反直觉点的。
二、阅读程序(程序输入不超过数组或字符串定义的范围;判断题正确填 √ ,错误填 × ;除特殊说明外,判断题 1.5 分,选择题 3 分,共计 40 分)
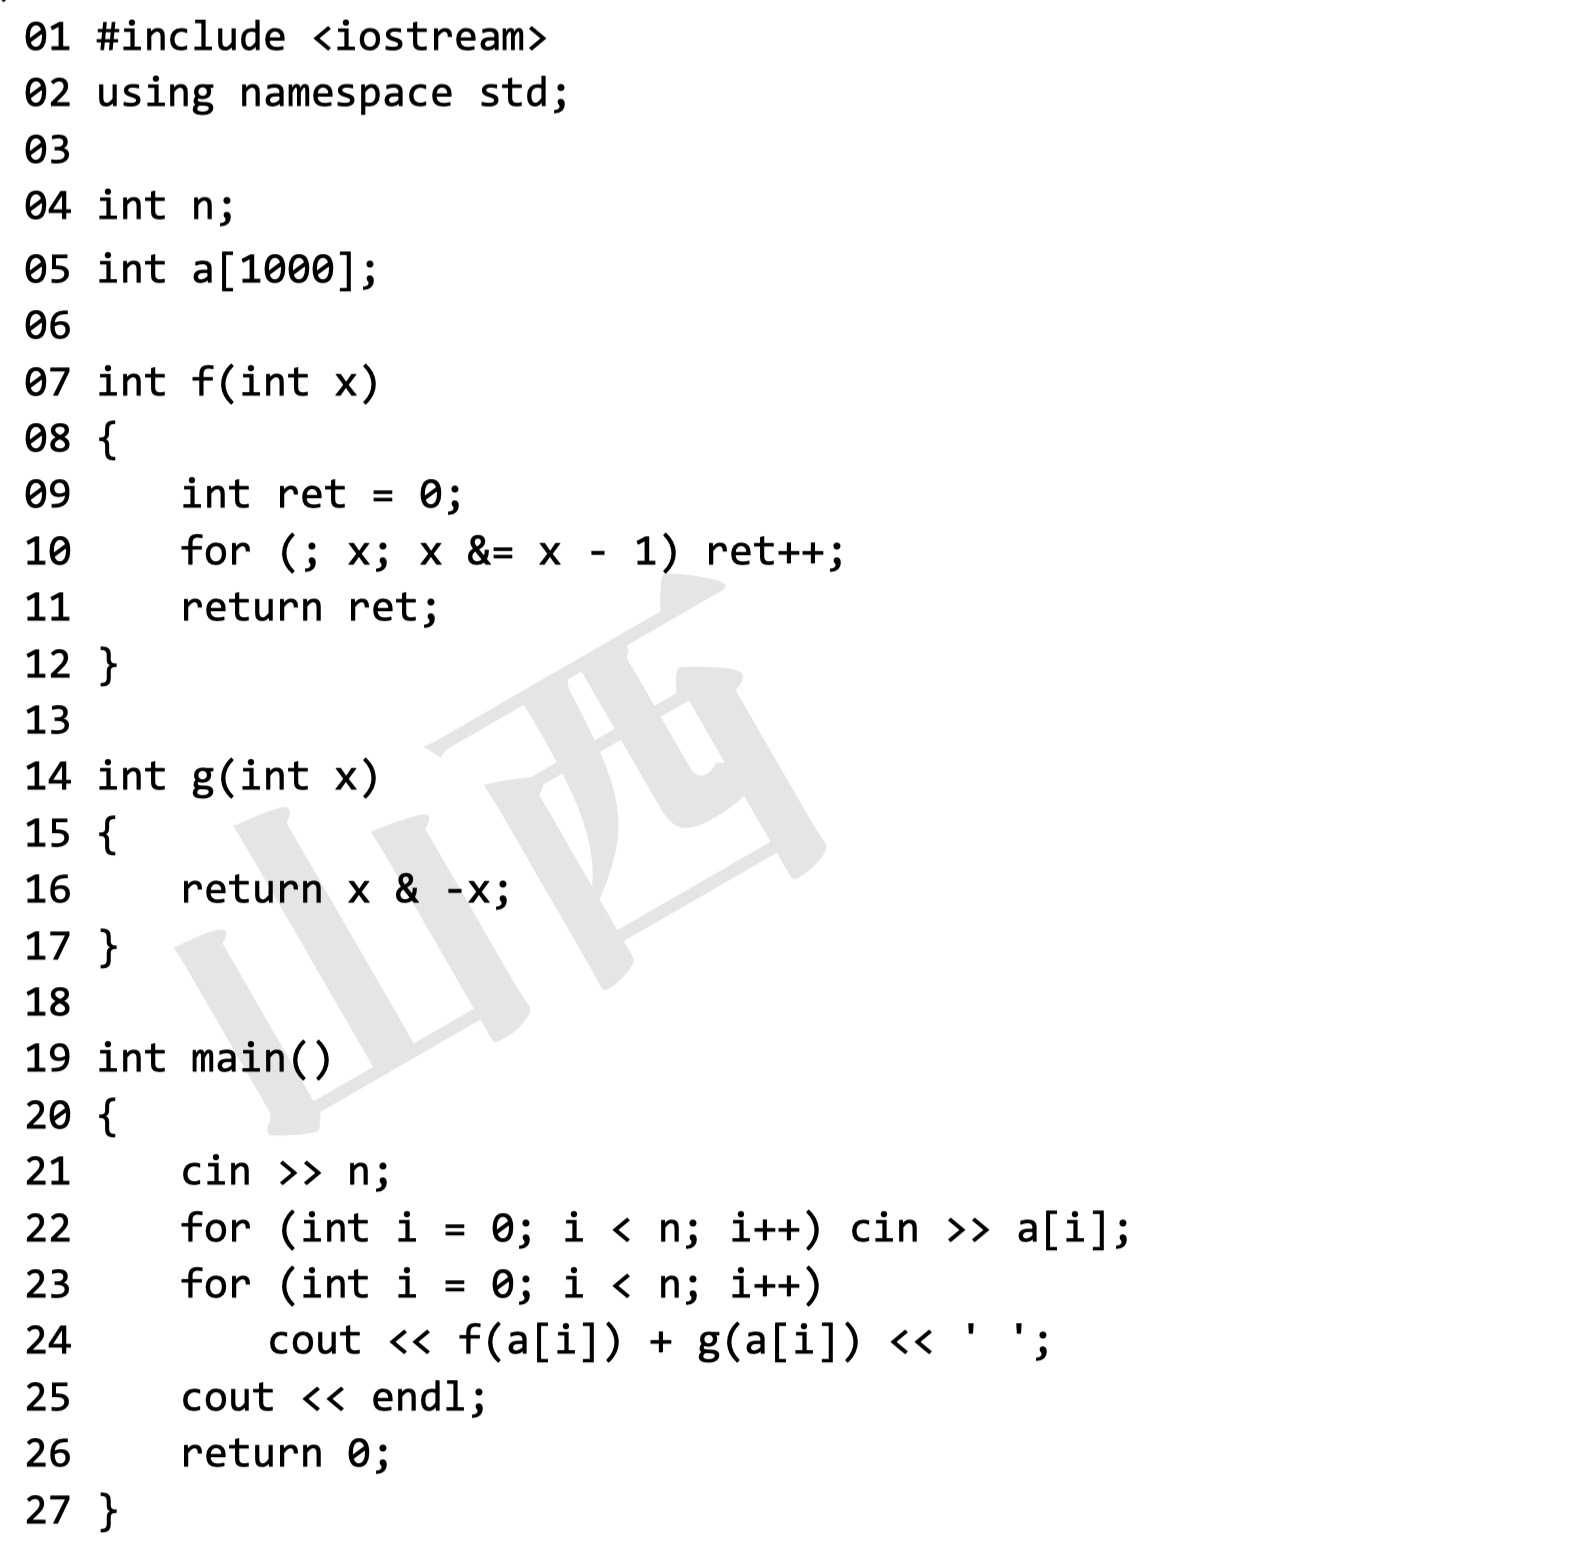
输入的 等于 时,程序不会发生下标越界。( )
输入的 必须全为正整数,否则程序将陷入死循环。( )
当输入为 5 2 11 9 16 10 时,输出为
3 4 3 17 5。( )
当输入为 1 511998 时,输出为 18。(
)
将源代码中 g
函数的定义(
行)移到 main 函数的后面,程序可以正常编译运行。( )
2 -65536 2147483647 时,输出为( )。A. 65532 33
B. 65552 32
C. 65535 34
D. 65554 33
(1)(1.5 分)
A. 正确 B. 错误
(2)(1.5 分)
A. 正确 B. 错误
(3)(1.5 分)
A. 正确 B. 错误
(4)(1.5 分)
A. 正确 B. 错误
(5)(1.5 分)
A. 正确 B. 错误
(6)(3 分)
A. 65532 33 B. 65552 32 C.
65535 34 D. 65554 33
答案:(1) B (2) B (3) B (4) A (5) B (6) B
⚠️ 本题原卷的程序在洛谷上是一张图片,下面是逐行转录后实际编译运行的结果。
f(x) 是 popcount(数二进制里有几个
)——x &= x - 1
每次抹掉最低位的那个
;
g(x) 是 lowbit(取出最低位的那个
所代表的值)。
实测:
| 输入 | 输出 |
|---|---|
5 / 2 11 9 16 10 |
3 4 3 17 4 |
1 / 511998 |
18 |
2 / -65536 2147483647 |
65552 32 |
3 / 0 -1 -2 |
0 33 33 |
(1) 错误(B):数组开的是
a[1000],合法下标
。
时循环会写到 a[1000],已经越界。
(2)
错误(B):实测输入负数不会死循环。x &= x - 1
对负数照样每次消掉一个
(补码下最多
32 个),必然结束。实测 0 -1 -2 正常输出
0 33 33。
(3) 错误(B):实测输出是
3 4 3 17 4,最后一个是 4 不是 5。 因为
,popcount
、lowbit
,。
📝 这种「给一串输出让你判断对不对」的题,只要有一个数不同就是错。 逐个算,别只算前两个就打勾。
(4)
正确(A):
的二进制是 1111100111111111110,popcount
、lowbit
,。实测确认。
(5) 错误(B):main 里调用了
g,若把 g 的定义挪到 main
后面又没加函数声明,编译直接报错。实测 g++ 报
error: 'g' was not declared in this scope。
📝 C++ 的规矩:使用之前必须先见过声明。
想把定义放后面,就得在前面补一行 int g(int x);。
(6)
65552 32(B):
的补码是 1111...10000000000000000(高 16 位全 1),popcount
、lowbit
,和为
;
有 31 个 1、lowbit
,和为
。实测确认。
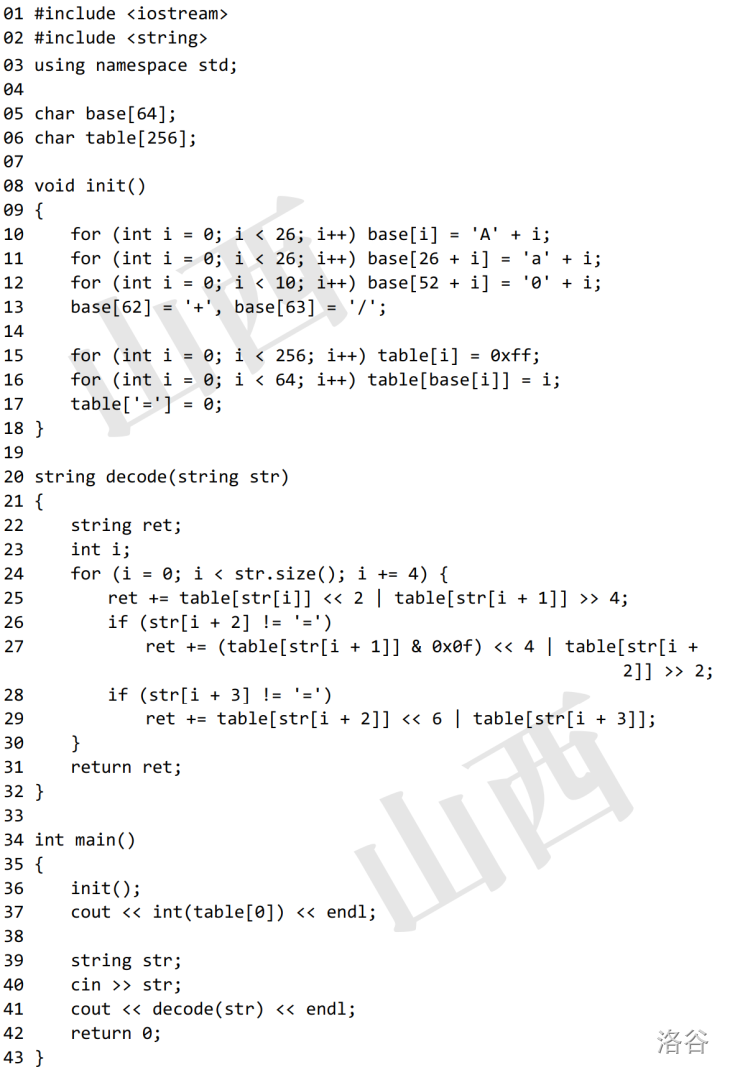
输出的第二行一定是由小写字母、大写字母、数字和 、 、 构成的字符串。( )
可能存在输入不同,但输出的第二行相同的情形。( )
输出的第一行为 。( )
设输入字符串长度为
,decode
函数的时间复杂度为( )
当输入为 时,输出的第二行为()。
(3.5 分)当输入为 时,输出的第二行为( )。
(1)(1.5 分)
A. 正确 B. 错误
(2)(1.5 分)
A. 正确 B. 错误
(3)(1.5 分)
A. 正确 B. 错误
(4)(3 分)
A. B. C. D.
(5)(3 分)
A. csp B. csq C. CSP D.
Csp
(6)(3.5 分)
A. ccf2021 B. ccf2022 C.
ccf 2021 D. ccf 2022
答案:(1) B (2) A (3) A (4) B (5) B (6) C
⚠️ 本题原卷程序在洛谷上也是图片,以下为逐行转录后实测。
这是一个 Base64 解码器。实测:
| 输入 | 第一行 | 第二行 |
|---|---|---|
Y3Nx |
-1 |
csq |
Y2NmIDIwMjE= |
-1 |
ccf 2021 |
QUJD |
-1 |
ABC |
(1)
错误(B):输出的第二行是解码之后的原文,可以是任意字节(中文、控制字符都行)。由「小写字母、大写字母、数字和
+、/、=」构成的是 Base64
编码本身,也就是输入,不是输出。
📝 这题在考「谁是编码、谁是原文」——方向别搞反。
(2) 正确(A):实测搜遍了 个 4 字符输入,撞车的有 1007617 组。 最直观的例子:
decode("AB==") = [00] decode("AC==") = [00]原因:第一个字节只用到 table[str[1]] >> 4(高 2
位),而 str[2] == '=' 时低 4 位那一步被 if
跳过了——str[1] 低 4
位的信息整个被丢掉,所以
B、C、D… 都得到同一个结果。
⚠️ 我一开始只在 64 个 Base64 字符里搜,结果是「0 组撞车」——把
= 加进字母表才找到反例。
这正是判断题的常见陷阱:「可能存在」只需要一个反例,而反例往往藏在边界字符上。
(3) 正确(A):table 初始化成
0xff,而 table 是
char(在常见平台上是有符号的),(char)0xff
就是
。table[0](字符
'\0')没被赋过其他值,所以 int(table[0]) 输出
。实测确认。
📝 char
默认有没有符号是「实现定义」的,但 x86/x64 上的 GCC、MSVC
都是有符号。这题就是在考这个。
(4)
(B):for (i = 0; i < str.size(); i += 4)
走一遍,每次常数工作量。
(5) csq(B):实测输出
csq。选项 A 的 csp
差在最后一个字母——Y3Nw 才是
csp。四个选项里有三个只差一个字母,必须真解码。
(6) ccf 2021(C):实测输出
ccf 2021(中间有空格)。选项 A、B
没空格,D 是 ccf 2022。
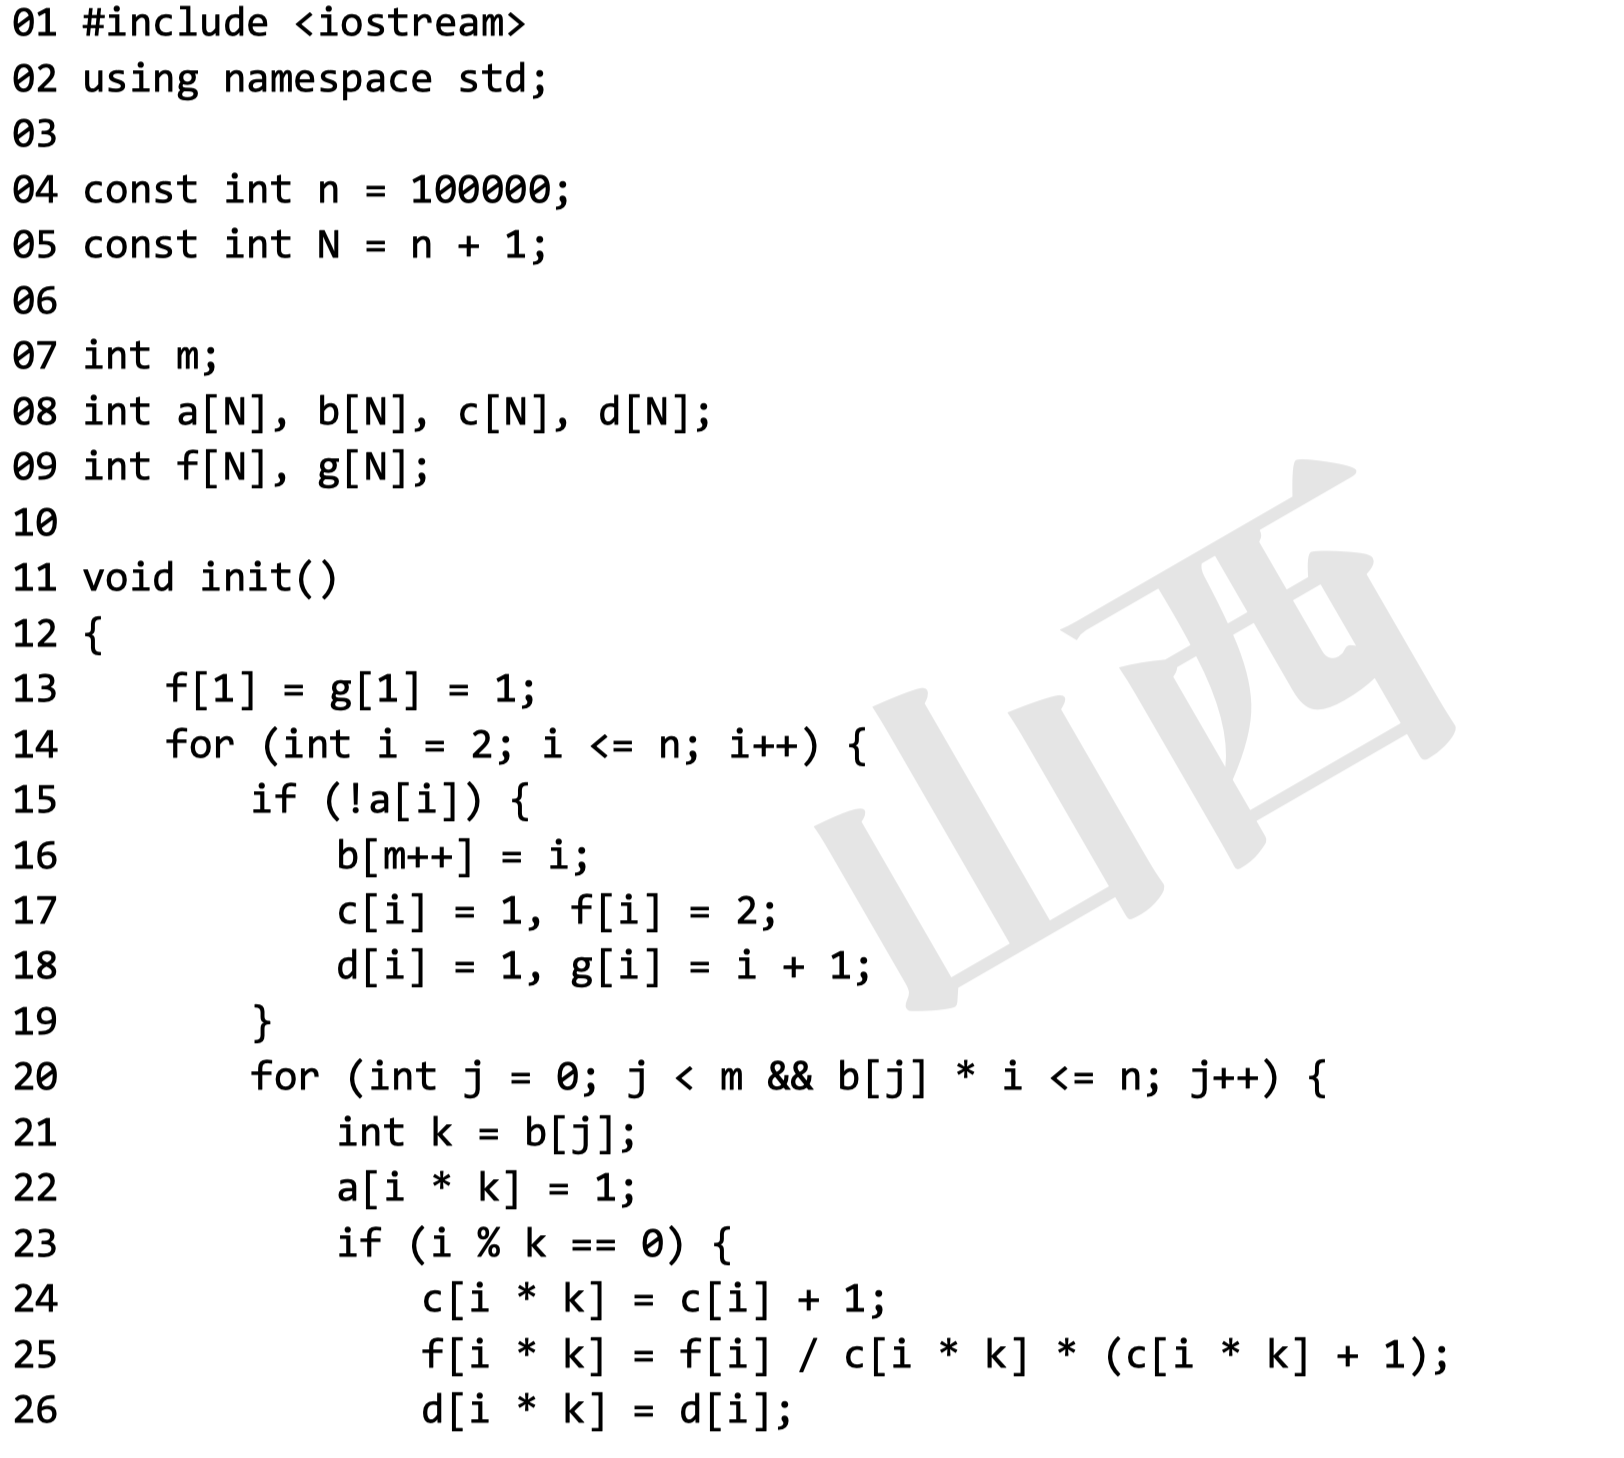
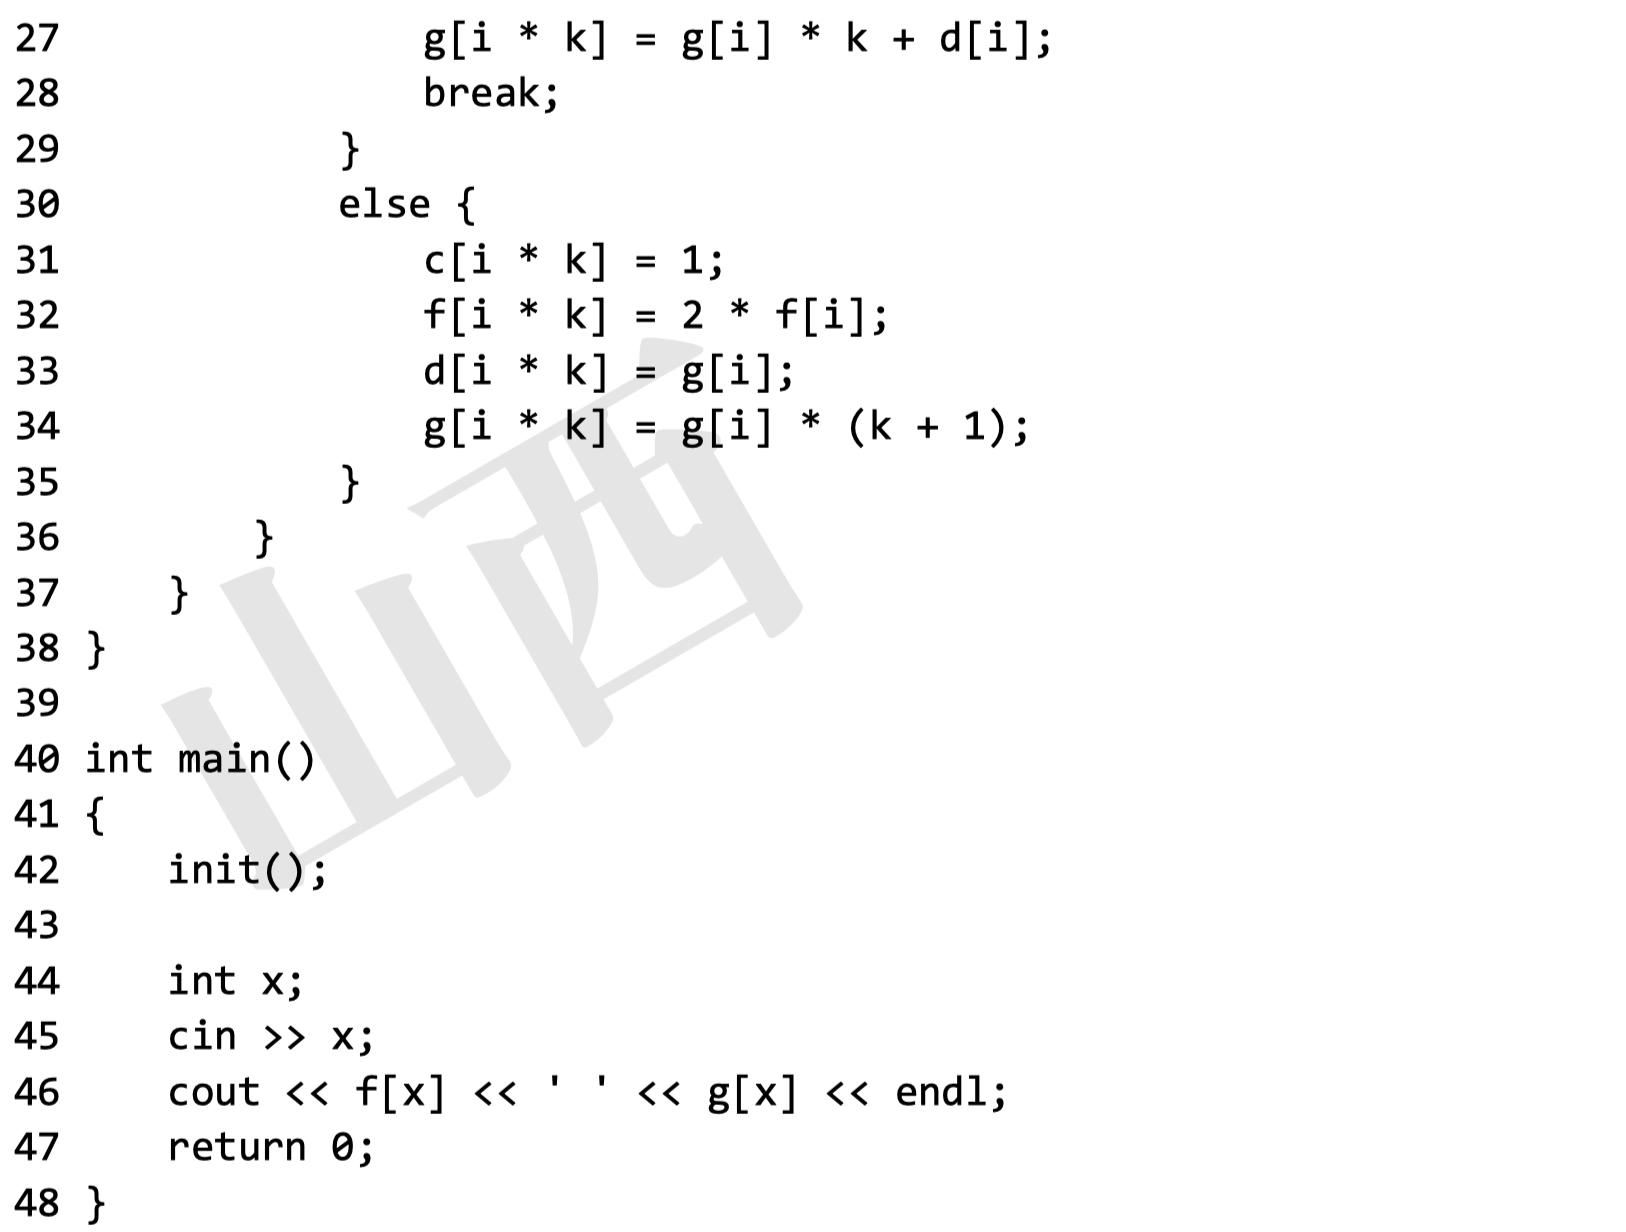
假设输入的 是不超过 的自然数,完成下面的判断题和单选题:
若输入不为 ,把第 13 行删去不会影响输出的结果。( )
(2 分) 第 25 行的
f[i] / c[i * k]可能存在无法整除而向下取整的情况。 (
)
(2 分) 在执行完 init() 后,f
数组不是单调递增的,但 g 数组是单调递增的。 ( )
init 函数的时间复杂度为( )。
在执行完 init()
后,
中有()个等于 2。
(4 分) 当输入为 时,输出为()。
(1)(1.5 分)
A. 正确 B. 错误
(2)(2 分)
A. 正确 B. 错误
(3)(2 分)
A. 正确 B. 错误
(4)(3 分)
A. B. C. D.
(5)(3 分)
A. 23 B. 24 C. 25 D. 26
(6)(4 分)
A. 15 1340 B. 15 2340 C.
16 2340 D. 16 1340
答案:(1) A (2) B (3) B (4) A (5) C (6) C
⚠️ 本题原卷程序在洛谷上是两张图片,以下为逐行转录后实测。
这是线性筛(欧拉筛) 的扩展:f[i] 是
的约数个数
,g[i]
是
的约数之和
。实测:
| 1 | 2 | 6 | 12 | 36 | 100 | 1000 | |
|---|---|---|---|---|---|---|---|
f[x] (约数个数) |
1 | 2 | 4 | 6 | 9 | 9 | 16 |
g[x] (约数之和) |
1 | 3 | 12 | 28 | 91 | 217 | 2340 |
(1) 正确(A):第 13 行是
f[1] = g[1] = 1;,只影响 f[1] 和
g[1]。实测删掉后,除了
从 1 1 变成
0 0,其余输入的输出完全一致。
(2) 错误(B):实测把整个
init()
跑完(),第
25 行的 f[i] / c[i*k] 一次都没有除不尽——不整除次数 =
0。 因为 c[i*k] = c[i]+1 恰好是 f[i]
的一个因子(约数个数公式里那一项)。
(3) 错误(B):实测 f 和
g 都不单调递增,而且都在
处第一次下降。
,。题目说「g
数组是单调递增的」——这半句就是错的,所以整句错。
📝 判断题里只要有一个分句错,整句就是错的。
这题前半句(f
不单调)对,后半句错,很容易被前半句带着打勾。
(4)
(A):线性筛的招牌就是每个合数只被它的最小质因子筛掉一次(if (i % k == 0) break;
保证了这一点),总复杂度
。
📝 和埃氏筛区分:埃氏筛是
,会重复筛;线性筛是
,靠那句
break。
(5)
(C):f[i] == 2
意味着
恰好有 2 个约数,也就是
是质数。
以内质数有 25 个。实测确认。
(6)
16 2340(C):,约数个数
,约数之和
。实测确认。
📝 这两个公式必背: 时,
(1)(Josephus 问题) 有 个人围成一个圈,依次标号 至 。从 号开始,依次 交替报数,报到 的人会离开,直至圈中只剩下一个人。求最后剩下人的编号。
试补全模拟程序。 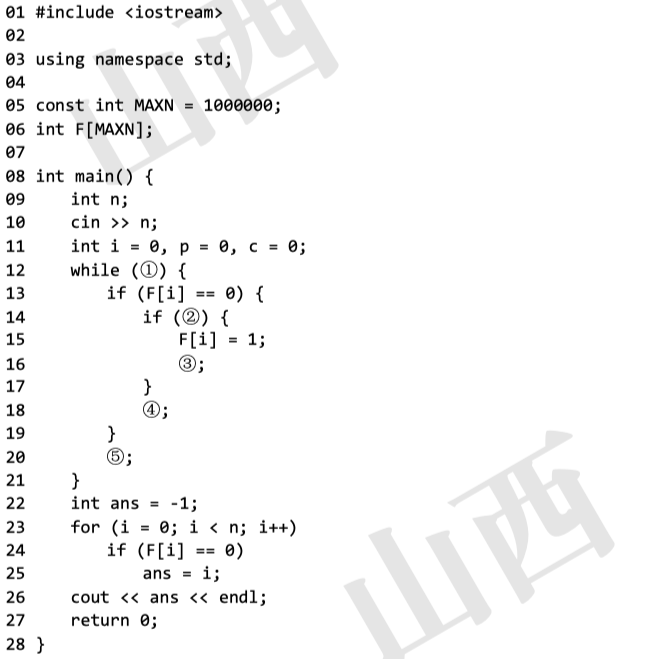
①处应填( )
A.i < n
B.c < n
C.i < n- 1
D.c < n-1
②处应填( )
A.i % 2 == 0
B.i % 2 == 1
C.p
D.!p
③处应填( )
A.i++
B.i = (i + 1) % n
C.c++
D.p ^= 1
④处应填( )
A.i++
B.i = (i + 1) % n
C.c++
D.p ^= 1
⑤处应填( )
A.i++
B.i = (i + 1) % n
C.c++
D.p ^= 1
(1)(3 分)
A. i < n B. c < n C.
i < n - 1 D. c < n - 1
(2)(3 分)
A. i % 2 == 0 B. i % 2 == 1 C.
p D. !p
(3)(3 分)
A. i++ B. i = (i + 1) % n C.
c++ D. p ^=1
(4)(3 分)
A. i++ B. i = (i + 1) % n C.
c++ D. p ^=1
(5)(3 分)
A. i++ B. i = (i + 1) % n C.
c++ D. p ^=1
答案:① D ② C ③ C ④ D ⑤ B
⚠️ 本题原卷程序在洛谷上是图片,以下为逐行转录后实测。
约瑟夫问题:
人围圈,从
号开始交替报
,报到
的出局。F[i] 标记第
人是否已出局,p 是当前该报的数,c
是已出局人数。
| 空 | 填 | 为什么 |
|---|---|---|
| ① | c < n - 1 |
淘汰到只剩 1 人就停 |
| ② | p |
报到
(即
p 为真)才出局 |
| ③ | c++ |
出局人数 |
| ④ | p ^= 1 |
只有还在圈里的人才报数,所以翻转放在
if (F[i]==0) 里面 |
| ⑤ | i = (i + 1) % n |
绕圈走 |
实测对照(另用 Python 独立模拟同一规则作为参照):
| 1 | 2 | 3 | 4 | 5 | 6 | 7 | 10 | |
|---|---|---|---|---|---|---|---|---|
| 标准答案的程序 | 0 | 0 | 2 | 0 | 2 | 4 | 6 | 4 |
| Python 独立模拟 | 0 | 0 | 2 | 0 | 2 | 4 | 6 | 4 |
错误填法实测:
| 改动 | 实测 |
|---|---|
①填 i < n |
全部死循环(i 一直 %n
转圈,条件永远成立) |
②填 i % 2 == 1 |
全部死循环(按位置奇偶判,位置不会变,圈里的人淘汰不完) |
⑤填 i++ |
输出
(应为
)、
输出
(应为
)——i
冲出数组,没绕回来 |
📝 ④ 放在哪一层是本题最难的一空。
p ^= 1 必须在 if (F[i] == 0)
里面——已经出局的人不再报数,如果放到外面(和 ⑤
并列),报数节奏就被死人带乱了。
⚠️ 约瑟夫问题是初赛完善程序的常客。
记住这个「标记数组 + 绕圈下标 i = (i+1) % n +
计数器」的骨架。
( 2 ) (矩形计数) 平面上有
个关键点,求有多少个四条边都和
轴或者
轴平行的矩形,满足四个顶点都是关键点。给出的关键点可能有重复,但完全重合的矩形只计一
次。 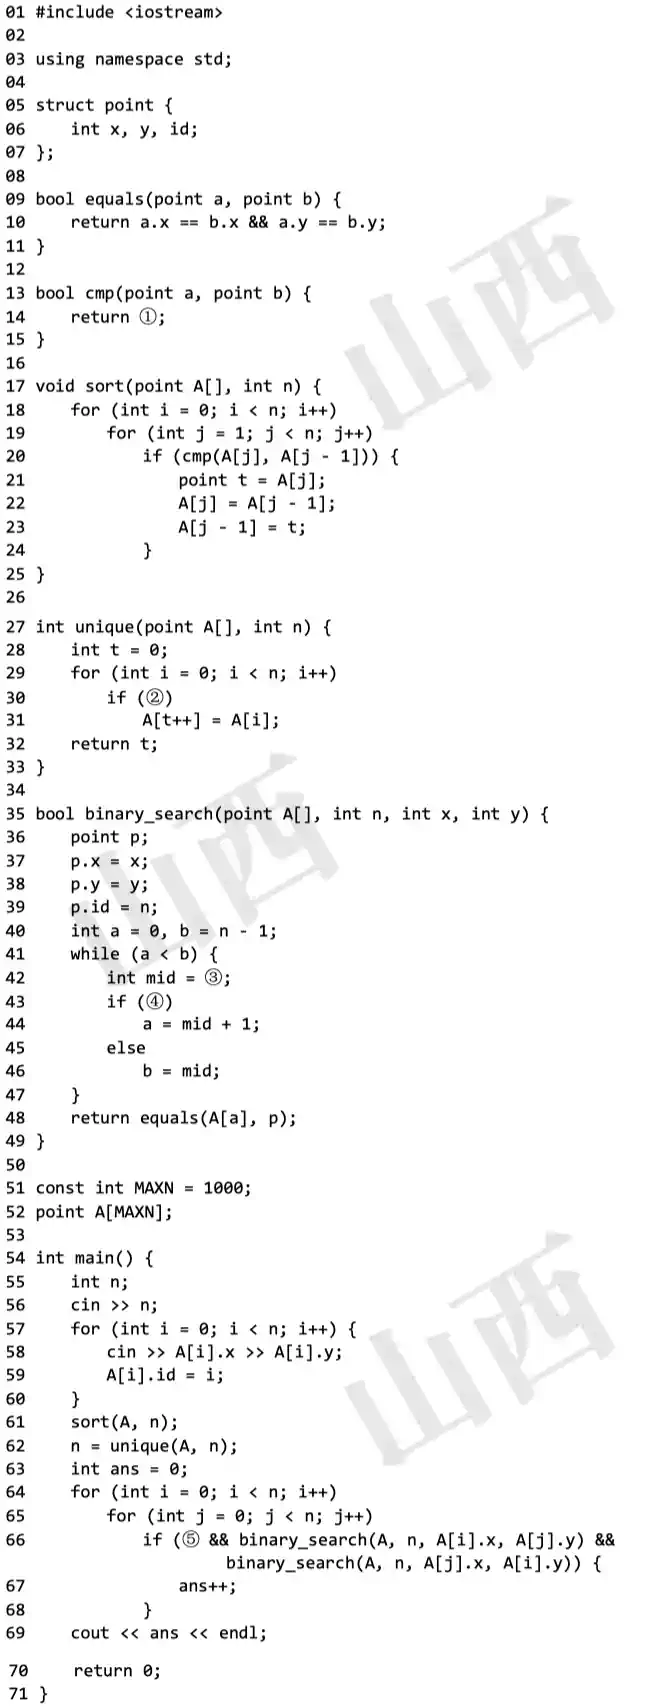 试补全枚举算法。
①处应填 ( )
A. a.x != b.x ? a.x < b.x : a.id < b.id
B. a.x != b.x ? a.x < b.x : a.y < b.y
C. equals(a, b) ? a.id < b.id : a.x < b.x
D.
equals(a, b) ? a.id < b.id : (a.x != b.x ? a.x < b.x : a.y < b.y)
②处应填 ( )
A. i == 0 || cmp(A[i], A[i - 1])
B. t == 0 || equals(A[i], A[t - 1])
C. i == 0 || !cmp(A[i], A[i - 1])
D. t == 0 || !equals(A[i], A[t - 1]) 41. ③处应填 ( )
A. b - (b - a) / 2 + 1
B. a + b + 1) >> 1
C. (a + b) >> 1
D. a + (b - a + 1) / 2
42. ④处应填 ( )
A. !cmp(A[mid], p)
B. cmp(A[mid], p)
C. cmp(p, A[mid])
D. !cmp(p, A[mid]) 43. ⑤处应填 ( )
A. A[i].x == A[j].x
B. A[i].id < A[j].id
C. A[i].x == A[j].x && A[i].id < A[j].id
D. A[i].x < A[j].x && A[i].y < A[j].y
(1)(3 分)
A. a.x != b.x ? a.x < b.x : a.id < b.id B.
a.x != b.x ? a.x < b.x : a.y < b.y C.
equals(a, b) ? a.id < b.id : a.x < b.x D.
equals(a, b) ? a.id < b.id : (a.x != b.x ? a.x < b.x : a.y < b.y)
(2)(3 分)
A. i == 0 || cmp(A[i], A[i - 1]) B.
t == 0 || equals(A[i], A[t - 1]) C.
i == 0 || !cmp(A[i], A[i - 1]) D.
t == 0 || !equals(A[i], A[t - 1])
(3)(3 分)
A. b - (b - a) / 2 + 1 B.
(a + b + 1) >> 1 C. (a + b) >> 1
D. a + (b - a + 1) / 2
(4)(3 分)
A. !cmp(A[mid], p) B. cmp(A[mid], p) C.
cmp(p, A[mid]) D. !cmp(p, A[mid])
(5)(3 分)
A. A[i].x == A[j].x B. A[i].id < A[j].id
C. A[i].x == A[j].x && A[i].id < A[j].id D.
A[i].x < A[j].x && A[i].y < A[j].y
答案:① B ② D ③ C ④ B ⑤ D
⚠️ 本题原卷程序在洛谷上是图片,以下为逐行转录后实测。
矩形计数:排序去重后,枚举两个点当矩形的左下角和右上角,再用二分查另外两个角是否存在。
| 空 | 填 | 为什么 |
|---|---|---|
| ① | a.x != b.x ? a.x < b.x : a.y < b.y |
按 字典序排 |
| ② | `t == 0 | |
| ③ | (a + b) >> 1 |
标准二分取中点 |
| ④ | cmp(A[mid], p) |
lower_bound 语义:比目标小就往右找 |
| ⑤ | A[i].x < A[j].x && A[i].y < A[j].y |
固定「左下 + 右上」,保证每个矩形只数一次 |
验证方法:我把 5 个空全部做成运行时开关,一次性枚举了全部 种填法,拿 7 组已知答案的数据(含重复点、含 网格该得 9 个矩形)去筛——
1024 种组合里,7 组数据全对的有且只有 1 种:① B ② D ③ C ④ B ⑤ D
⚠️ 我一开始把 ① 猜成了
D(equals(a,b) ? a.id < b.id : ...),实测直接输出
0。 原因值得记:binary_search 里构造的探针点
p.id = n,而数组里真实点的 id 都小于
n。若 cmp 在坐标相同时还去比
id,cmp(A[mid], p)
就会返回真,二分从匹配位置上跨过去,永远查不到。填
B(完全不看 id)才对。
📝 这就是「看着更严谨的写法反而是错的」的典型。 二分查找的比较函数必须和「查找目标」的定义严格一致——多比一个字段就会把目标滑掉。
📝 ⑤
为什么是「都小于」:矩形由一对对角点确定。若只写
A[i].x == A[j].x,数的就不是矩形了;若写成
A[i].id < A[j].id,同一个矩形会被两条对角线各数一次。只有「
和
都严格小于」才能唯一锁定「左下角 + 右上角」这一种配对。
在内存储器中每个存储单元都被赋予一个唯一的序号,称为()。
A. 地址 B. 序号 C. 下标 D. 编号
答案:A
内存里每个存储单元的唯一编号叫地址。CPU 就是靠地址找到数据的。
📝
和指针连起来记:指针变量存的就是「地址」。&x
取出 x 的地址,*p 按地址去取内容。
编译器的主要功能是( )。
A. 将源程序翻译成机器指令代码 B. 将源程序重新组合 C. 将低级语言翻译成高级语言 D. 将一种高级语言翻译成另一种高级语言
答案:A
编译器把源程序翻译成机器指令代码。
⚠️ C 说的「把低级语言翻译成高级语言」是反编译;D 说的「一种高级语言翻译成另一种」是转译工具,都不是编译器。
📝 这题和 CSP 2024 第 15 题是同一个考点,几乎每年都出,闭着眼也要选对。
设 x=true,y=true,z=false,以下逻辑运算表达式值为真的是(
)。
A. (y∨z)∧x∧z B. x∧(z∨y) ∧z C. (x∧y) ∧z D. (x∧y)∨(z∨x)
答案:D
,逐项算(已用程序核对):
| 选项 | 计算 | 值 |
|---|---|---|
| A. | 真 ∧ 真 ∧ 假 | 假 |
| B. | 真 ∧ 真 ∧ 假 | 假 |
| C. | 真 ∧ 假 | 假 |
| D. | 真 ∨ 真 | 真 |
📝 秒杀技巧: 是假,凡是「整个表达式最后要和 做 」的一定为假。 A、B、C 三个都以 收尾——一眼全灭,剩下的就是答案。
现有一张分辨率为 像素的 位真彩色图像。请问要存储这张图像,需要多大的存储空间?( )。
A. 16MB B. 4MB C. 8MB D. 2MB
答案:C
「 位真彩色」= 每个像素 位 = 字节。
📝 图像存储的固定套路:像素总数 × 每像素位数 ÷ 8 = 字节数。 常见位深: 位(256 色)、 位(真彩色)、 位(真彩色 + 透明通道)。
⚠️ 别忘了除以 换成字节,也别忘 。(这题和 CSP 2024 第 5 题是一对,那题是反过来问 bit。)
冒泡排序算法的伪代码如下:
输入:数组L, n ≥ k。输出:按非递减顺序排序的 L。
算法 BubbleSort:
   1. FLAG ← n //标记被交换的最后元素位置
   2. while FLAG > 1 do
   3.     k ← FLAG -1
   4.     FLAG ← 1
   5.     for j=1 to k do
   6.         if L(j) > L(j+1) then do
   7.              L(j)  ↔ L(j+1)
   8.              FLAG ← j
对 个数用以上冒泡排序算法进行排序,最少需要比较多少次?( )。
A. B. C. D.
答案:C
看伪代码里的 FLAG
机制:如果某一轮一次交换都没发生,FLAG
会被置成
,while FLAG > 1
立刻结束。
所以数组本来就有序时,只需跑一轮内层循环,比较 次就退出。
📝 这是「带提前退出的冒泡排序」,最好情况 、最坏 。不带提前退出的版本,比较次数恒为 ,与数据无关——两个版本要分清。
⚠️ 题目问的是最少比较次数。看到「最少 / 最好情况」就去想「数据已经排好序会怎样」。
设 是 个实数的数组,考虑下面的递归算法:
XYZ (A[1..n])
1.  if n=1 then return A[1]
2.  else temp ← XYZ (A[1..n-1])
3.  if temp < A[n]
4.  then return temp
5.  else return A[n]
请问算法 XYZ 的输出是什么?()。
A. A 数组的平均 B. A 数组的最小值 C. A 数组的中值 D. A 数组的最大值
答案:B
XYZ(A[1..n]) 递归求前
个的结果 temp,然后返回 temp 和
A[n]
中较小的那个(if temp < A[n] then return temp else return A[n])。
所以它求的是数组的最小值。
📝 看不懂递归就代小数据: 返回 ; 返回 ; 返回 ……规律立刻出来。
⚠️ 把比较方向看反就会选 D。读递归先找那个 if
到底留下了谁。
链表不具有的特点是()。
A. 可随机访问任一元素 B. 不必事先估计存储空间 C. 插入删除不需要移动元素 D. 所需空间与线性表长度成正比
答案:A
链表不能随机访问——要拿第 个元素只能从头一个个走,。这正是它和数组最大的差别。
B、C、D 说的都是链表具有的特点。
📝 见 CSP 2022 第 4 题的对照表。一句话:数组读得快,链表改得快。
⚠️ 这题问的是「不具有」。
有 个顶点的无向图至少应该有( )条边才能确保是一个连通图。
A. 9 B. 10 C. 11 D. 12
答案:A
个顶点的无向图要连通,最少需要 条边(此时它是一棵树)。 个顶点 → 条边。
📝 三个必背结论:
| 图 | 最少边数 |
|---|---|
| 无向连通图 | (树) |
| 有向强连通图 | (一个环,见 CSP 2022 第 9 题) |
| 无向图保证连通(不管怎么连) |
⚠️ 第三行才是「无论边怎么摆都必然连通」的答案( 个点时是 )。本题选项里最大才 ,说明问的是第一行。读题时看清是「最少需要多少条边能连通」还是「至少多少条边才能保证一定连通」。
二进制数 转换成十进制数是( )。
A. 11 B. 10 C. 13 D. 12
答案:A
📝 二进制权值从右往左:。背到 。
个小朋友并排站成一列,其中有两个小朋友是双胞胎,如果要求这两个双胞胎必须相邻,则有( )种不同排列方法?
A. 48 B. 36 C. 24 D. 72
答案:A
捆绑法:双胞胎捆成一个整体 → 个单位排列 ;整体内部两人可换 。
📝 和 CSP 2024 第 14 题( 男 女、 女相邻)完全同型。「必须相邻」= 捆绑 + 乘内部排列,这两年都考过。
下图中所使用的数据结构是( )。

A. 栈 B. 队列 C. 二叉树 D. 哈希表
答案:A
图示的操作序列是:压入 A → 压入 B → 弹出 B → 压入 C。
关键在弹出的是 B——B 是最后压进去的,却最先出来,这就是后进先出(LIFO),也就是栈。
📝 图里还有一个特征:新元素总是加在顶部、也从顶部取走,只有一个开口。队列则是一头进、另一头出。
⚠️ 如果图里弹出的是 A(最先进去的那个),答案就是队列了。看图先找「谁先出去」。
独根树的高度为 。具有 个结点的完全二叉树的高度为( )。
A. 7 B. 8 C. 5 D. 6
答案:D
「独根树高度为 」这个约定下,高度为 的二叉树最多有 个结点:
所以高度是 。
📝 完全二叉树的高度公式:。 , ✓
⚠️ 又是那个约定问题——题目特意写了「独根树的高度为 」。如果按根高为 算就是 ,正好是选项 C。
干支纪年法是中国传统的纪年方法,由 个天干和 个地支组合成 个天干地支。由公历年份可以根据以下公式和表格换算出对应的天干地支。
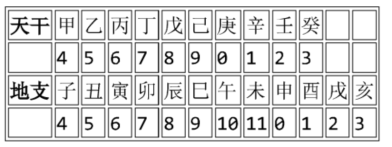
例如,今年是 年, 除以 余数为 ,查表为"庚”; 除以 ,余数为 ,查表为“子” 所以今年是庚子年。
请问 年的天干地支是( )
A. 己酉 B. 己亥 C. 己丑 D. 己卯
答案:C
题目已经给了对照锚点: 年, 庚, 子。
对 :
所以是 己丑年。
📝 分不出来就用题目自带的例子当锚点往后数,比背天干地支表可靠得多。
⚠️ :,。这一步手算容易错,多验一遍。
个三好学生名额分配到 个班级,每个班级至少有一个名额,一共有( )种不同的分配方案。
A. 84 B. 72 C. 56 D. 504
答案:A
个相同的名额分给 个不同的班级、每班至少 个——隔板法:
把 个名额排成一行,中间有 个空隙,插 块隔板分成 段:
📝 隔板法口诀: 个相同物品分给 个不同的人、每人至少一个 = 。
⚠️ 必须是「相同物品 + 不同的人 + 每人至少一个」三个条件同时满足才能用。如果允许有人分不到,就要先给每人预支一个(变成 )。
有五副不同颜色的手套(共 只手套,每副手套左右手各 只),一次性从中取 只手套,请问恰好能配成两副手套的不同取法有( )种。
A. 120 B. 180 C. 150 D. 30
答案:A
「恰好配成两副」= 取的 只手套里,正好有 副是完整的,剩下 只必须来自不同的副。
已用程序穷举全部 种取法验证:恰好两副的确实是 120 种。
⚠️ 「恰好」两个字是关键——剩下那 只绝不能又凑成一副,否则就变成三副了。漏掉这个限制会算成 ,正好是选项 C。
二、阅读程序(程序输入不超过数组或字符串定义的范围;判断题正确填 √,错误填 ×。除特殊说明外,判断题 分,选择题 分,共计 分)
#include <cstdlib>
#include <iostream>
using namespace std;

char encoder[26] = {'C','S','P',0};
char decoder[26];

string st;

int main()  {
  int k = 0;
  for (int i = 0; i < 26; ++i)
    if (encoder[i] != 0) ++k;
  for (char x ='A'; x <= 'Z'; ++x) {
    bool flag = true;
    for (int i = 0; i < 26; ++i)
      if (encoder[i] ==x) {
        flag = false;
        break;
      }
      if (flag) {
        encoder[k]= x;
        ++k;
      }
  }
  for (int i = 0; i < 26; ++i)
     decoder[encoder[i]- 'A'] = i + 'A';
  cin >> st;
  for (int i = 0; i < st.length( ); ++i)
    st[i] = decoder[st[i] -'A'];
  cout << st;
  return 0;
}
•判断题
i < 26 改为
i < 16,程序运行结果不会改变。( )i < 26 改为
i < 16,程序运行结果不会改变。( )•单选题
5) 若输出的字符串为 ,则下列说法正确的是( )。
6)若输出的字符串为 ,则下列说法正确的是( )。
(1)(1.5 分)
A. 正确 B. 错误
(2)(1.5 分)
A. 正确 B. 错误
(3)(1.5 分)
A. 正确 B. 错误
(4)(1.5 分)
A. 正确 B. 错误
(5)(3 分)
A. 输入的字符串中既有 S 又有 P B. 输入的字符串中既有 S 又有 B C. 输入的字符串中既有 A 又有 P D. 输入的字符串中既有 A 又有 B
(6)(3 分)
A. 输入的字符串中既有 P 又有 K B. 输入的字符串中既有 J 又有 R C. 输入的字符串中既有 J 又有 K D. 输入的字符串中既有 P 又有 R
答案:(1) A (2) B (3) A (4) B (5) A (6) D
替换密码:encoder 先放
C S P,再把剩下没用过的字母按 A→Z
顺序补齐;decoder 是它的逆映射。实测:
encoder: C S P A B D E F G H I J K L M N O Q R T U V W X Y Z
decoder: D E A F G H I J K L M N O P Q C R S B T U V W X Y Z
即
C→A、S→B、P→C、A→D、B→E……
| 输入 | 输出 |
|---|---|
CSPCSPCSPC |
ABCABCABCA |
PRNPRNPRNPRN |
CSPCSPCSPCSP |
Z |
Z ← 关键 |
(1)
正确(A):decoder[st[i] - 'A'],输入若不是大写字母,下标就会跑出
。
(2) 错误(B):实测有 7
个字母是「不动点」:T、U、V、W、X、Y、Z——它们在
encoder 里的位置恰好等于自己。输入 Z 输出还是
Z,输入输出一模一样。
📝 看到「一定 / 总是」,先去找反例。 这里只要注意到「C、S、P 被提到最前面,只把前面的字母挤后了几位,末尾那几个字母根本没被挪动」,反例就出来了。
(3) 正确(A):那一行是数 encoder
里有几个非零元素。非零的只有开头 C S P 三个,改成
i < 16 照样数出
。实测五组输入输出完全一致。
(4) 错误(B):那一行是建 decoder
表。改成 i < 16 后,encoder 后
个字母的映射没建立,decoder 对应位置全是
——实测输出直接变成带空白的乱码。
(5) A:输出 ABCABCABCA 说明输入是
CSPCSPCSPC,既有 S 又有 P。
(6) D:输出 CSPCSPCSPCSP。反查:输出
C ← 输入 P,输出 S ← 输入
R,输出 P ← 输入 N。所以输入是
PRNPRNPRNPRN,既有 P 又有
R。实测确认。
📝 (5)(6) 都要「反着查表」。 别拿
encoder 直接读——程序用的是
decoder,方向正好相反。
#include <iostream>
using namespace std;

long long n, ans;
int k, len;
long long d[1000000];

int main() {
  cin >> n >> k;
  d[0] = 0;
  len= 1;
  ans = 0;
  for (long long i = 0; i <n; ++i) {
    ++d[0];
    for (int j = 0; j + 1<len; ++j) {
      if (d[j] == k) {
        d[j] = 0;
        d[j + 1] += 1;
        ++ans;
      }
    }
    if (d[len- 1] == k) {
      d[len - 1] = 0;
      d[len] =1;
      ++len;
      ++ans;
    }
  }
  cout << ans << endl;
  return 0;
}
假设输入的 是不超过 的正整数, 都是不超过 的正整数,完成下面的判断题和单选题:
若输入的 等于:,输入的 为 ,则输出等于( )。
若输入的 等于 (即 ),输入的 为 ,则输出等于( )。
若输入的 等于 ,输入的 为 ,则输出等于( )。
(1)(1.5 分)
A. 正确 B. 错误
(2)(1.5 分)
A. 正确 B. 错误
(3)(1.5 分)
A. 正确 B. 错误
(4)(3 分)
A. B. C. D.
(5)(3 分)
A. B. C. D.
(6)(3 分)
A. B. C. D.
答案:(1) B (2) B (3) A (4) D (5) B (6) D
d[] 是一个
进制计数器,从
开始加
加
次,ans 统计总进位次数,len
是当前位数。实测小数据:
| 输入 | 输出 ans |
len |
|---|---|---|
3 1 |
3 | 2 |
10 1 |
10 | 2 |
1 2 |
0 | 1 |
8 2 |
7 | 4 |
27 3 |
13 | 4 |
999 10 |
108 | 3 |
(1)
错误(B):
时实测 len 恒为
(),而不是
。比如
时 len = 2。
(2)
错误(B):
时实测 len = 1,而
不成立。
时
len = 2,
也不成立。
(3) 正确(A):d[] 存的就是
的
进制表示,len 是位数,所以
必然成立。实测
:len=4,
✓
(4) (D): 时每加一次都进位一次,实测 次输入就是 次进位。
(5) (B):进位总数 。、 时是 。已用程序在小数据上验证公式无误。
(6) (D):同一公式,、 时算得 11112222444453,与 D 完全吻合(A、B、C 三个都差了几位数字)。
📝 这题的核心公式一定要记住:
它和「 里质因子 的个数」是同一个公式(勒让德公式),初赛数学题也考。
⚠️ 大到 ,绝不可能真去模拟。看到这种数据范围就知道必须找公式。
#include <algorithm>
#include <iostream>
using namespace std;

int n;
int d[50][2];
int ans;

void dfs(int n, int sum) {
  if (n == 1) {
    ans = max(sum, ans);
    return;
  }
  for (int i = 1; i < n; ++i) {
    int a = d[i - 1][0], b = d[i - 1][1];
    int x = d[i][0], y = d[i][1];
    d[i - 1][0] = a + x;
    d[i - 1][1] = b + y;
    for (int j = i; j < n - 1; ++j)
      d[j][0] = d[j + 1][0], d[j][1] = d[j + 1][1];
    int s = a + x + abs(b - y);
    dfs(n - 1, sum + s);
    for (int j = n - 1; j > i; --j)
      d[j][0] = d[j - 1][0], d[j][1] = d[j - 1][1];
    d[i - 1][0] = a, d[i - 1][1] = b;
    d[i][0] = x, d[i][1] = y;
  }
}

int main() {
  cin >> n;
  for (int i = 0; i < n; ++i)
  cin >> d[i][0];
  for (int i = 0; i < n;++i)
     cin >> d[i][1];
  ans = 0;
  dfs(n, 0);
  cout << ans << endl;
  return 0;
}
假设输入的
是不超过
的正整数,d[i][0]、d[i][1] 都是不超过
的正整数,完成下面的判断题和单选题:
判断题
d[i][0] 和
d[i][1] 的任意一个。( )单选题
若输入的 为 ,接下来的输入是 个 和 个 ,则输出为( )。
若输入的 为 ,接下来的输入是 个 和 个 ,则输出为( )。
(4 分)若输入的 为 ,接下来的输入是 到 ,以及 到 ,则输出为( )。
(1)(1.5 分)
A. 正确 B. 错误
(2)(1.5 分)
A. 正确 B. 错误
(3)(1.5 分)
A. 正确 B. 错误
(4)(3 分)
A. 1890 B. 1881 C. 1908 D. 1917
(5)(3 分)
A. 2000 B. 2010 C. 2030 D. 2020
(6)(4 分)
A. 2440 B. 2220 C. 2240 D. 2420
答案:(1) B (2) A (3) B (4) B (5) C (6) C
程序枚举所有「相邻合并」的顺序,求最大总得分。每次把相邻两组 和 合并,得分 。
⚠️ 这题的三个单选()根本跑不完——朴素 DFS 要枚举 种顺序。我用区间 DP 复刻了同一个递推:
并在 的 12 组数据上与原程序逐一对拍,结果完全一致,再用它外推大数据。
(1)
错误(B):
时 dfs(0, 0) 里的 for (i = 1; i < 0; ++i)
一次都不进,直接返回。实测输入 0 正常输出
0,退出码 0,既不死循环也不报错。
(2) 正确(A):全 时每次合并得分都是 ,总分 。
(3) 错误(B):实测输入
1 / 9 / 0(即
)时输出
0,而
d[0][0] = 9。
时根本没有合并,ans 停在初值
。
📝 又是 这个边界。(CSP 2023 第 18 题也栽在 上。)看到「一定 / 总是」,先试最小的那个输入。
(4) (B): 个 、第二维全 , 恒为 ,只剩第一维的合并代价。要最大就让合并树尽量深(一个个往上叠):。
(5) (C): 个 + 个 ,第一维恒 ,只剩 。顺次合并得 。
(6) (C):、两维都是 ,DP 算得 2240。
📝 「求最大合并代价」的通用直觉:让合并树尽可能不平衡(排成一条链),这样每个元素被重复累加的次数最多。求最小才是哈夫曼那种「每次挑最小的两个」。
三、完善程序(单选题,每小题 分,共计 分)
1.(质因数分解)给出正整数 ,请输出将 质因数分解的结果,结果从小到大输出。
例如:输入
,程序应该输出
2 2 2 3 5,表示:。输入保证
。
提示:先从小到大枚举变量 ,然后用 不停试除 来寻找所有的质因子。
试补全程序。
#include <cstdio>
using namespace std;
int n, i;

int main() {
  scanf("%d", &n);
  for(i = ①; ② <=n; i ++){
    ③{
      printf("%d ", i);
      n = n / i;
    }
  }
  if(④)
    printf("%d ", ⑤);
  return 0;
}
1)①处应填( )
2)②处应填( )
3)③处应填( )
4)④处应填( )
5)⑤处应填( )
(1)(3 分)
A. 1 B. n-1 C. 2 D.
0
(2)(3 分)
A. n/i B. n/(i*i) C. i*i D.
i*i*i
(3)(3 分)
A. if(n%i==0) B. if(i*i<=n) C.
while(n%i==0) D. while(i*i<=n)
(4)(3 分)
A. n>1 B. n<=1 C.
i<n/i D. i+i<=n
(5)(3 分)
A. 2 B. n/i C. n D.
i
答案:① C ② C ③ C ④ A ⑤ C
质因数分解:从
开始试除,while 把同一个质因子除干净,最后若剩下的
,它本身就是一个大质因子。
| 空 | 填 | 为什么 |
|---|---|---|
| ① | 2 |
从最小的质数开始 |
| ② | i * i |
只需试到 |
| ③ | while(n % i == 0) |
必须是 while 不是
if,同一个质因子可能有多个 |
| ④ | n > 1 |
剩下的是一个大质因子 |
| ⑤ | n |
把它打印出来 |
逐个选项实测(输入 120 应输出
2 2 2 3 5):
| 改动 | 实测 |
|---|---|
| 标准答案 | 120 → 2 2 2 3 5 1024 → 2×10 10^9+7 → 1000000007
✓ |
①填 1 |
死循环(n % 1 == 0
恒成立,n = n/1 永远不变) |
②填 n / i |
死循环 / 超时 |
③填 if |
120 → 2 3 4 5(每个因子只除一次,后面全乱) |
⑤填 i |
97 → 10、10^9+7 → 31623(打印的是循环变量不是剩下的
) |
📝 ④⑤ 那个收尾是整道题最容易漏的地方。 循环只试到
,所以大于
的那个质因子永远进不了循环——比如
本身是质数时,循环一次都不打印。「除完之后如果
n > 1,把它补印出来」是固定收尾。
⚠️ 试除到 是把 降到 的关键, 时前者必超时。这和 CSP 2022 第 19 题(枚举因数)是同一个套路。
(最小区间覆盖)给出 个区间,第 个区间的左右端点是 。现在要在这些区间中选出若干个,使得区间 被所选区间的并覆盖(即每一个 都在某个所选的区间中)。保证答案存在,求所选区间个数的最小值。
输入第一行包含两个整数 和 ()
接下来 行,每行两个整数 ()。
提示:使用贪心法解决这个问题。先用 的时间复杂度排序,然后贪心选择这些区间。
试补全程序。
   #include <iostream>

   using namespace std;

   const int MAXN = 5000;
   int n, m;
   struct segment { int a, b; } A[MAXN];

   void sort() // 排序
   {
     for (int i = 0; i < n; i++)
     for (int j = 1; j < n; j++)
     if (①)
         {
           segment t = A[j];
           ②
         }
   }

   int main()
   {
     cin >> n >> m;
     for (int i = 0; i < n; i++)
       cin >> A[i].a >> A[i]・b;
     sort();
     int p = 1;
     for (int i = 1; i < n; i++)
       if (③)
         A[p++] = A[i];
     n = p;
     int ans =0, r = 0;
     int q = 0;
     while (r < m)
     {
       while (④)
         q++;
       ⑤;
       ans++;
     }
     cout << ans << endl;
     return 0;
   }
1)①处应填( )
2)②处应填( )
3)③处应填( )
4)④处应填( )
5)⑤处应填( )
(1)(3 分)
A. A[j].b>A[j-1].b B. A[j].a<A[j-1].a
C. A[j].a>A[j-1].a D.
A[j].b<A[j-1].b
(2)(3 分)
A. A[j+1]=A[j];A[j]=t; B.
A[j-1]=A[j];A[j]=t; C. A[j]=A[j+1];A[j+1]=t;
D. A[j]=A[j-1];A[j-1]=t;
(3)(3 分)
A. A[i].b>A[p-1].b B. A[i].b<A[i-1].b
C. A[i].b>A[i-1].b D.
A[i].b<A[p-1].b
(4)(3 分)
A. q+1<n&&A[q+1].a<=r B.
q+1<n&&A[q+1].b<=r C.
q<n&&A[q].a<=r D.
q<n&&A[q].b<=r
(5)(3 分)
A. r=max(r,A[q+1].b) B. r=max(r,A[q].b) C.
r=max(r,A[q+1].a) D. q++
答案:① B ② D ③ A ④ A ⑤ B
最小区间覆盖的贪心:按左端点排序 → 去掉被覆盖的无用区间 → 每次在「够得着」的区间里挑右端点最远的。
| 空 | 填 | 为什么 |
|---|---|---|
| ① | A[j].a < A[j-1].a |
冒泡排序,按左端点升序 |
| ② | A[j] = A[j-1]; A[j-1] = t; |
配合 t = A[j] 完成交换 |
| ③ | A[i].b > A[p-1].b |
只保留右端点比已保留的最后一个更远的 |
| ④ | q + 1 < n && A[q+1].a <= r |
只要下一个区间够得着当前右边界就往前推 |
| ⑤ | r = max(r, A[q].b) |
用当前区间把右边界推远 |
实测:14 组乱序随机数据,标准答案 14/14 全对(期望值由暴力枚举最小覆盖数得到);四个错误填法全部翻车:
| 改动 | 实测 |
|---|---|
①填 A[j].a > A[j-1].a |
错 4/14(排成降序,贪心整个反了) |
②填 A[j+1] = A[j]; A[j] = t; |
错 9/14(不是交换,是把数据覆盖坏了) |
③填 A[i].b > A[i-1].b |
错 1/14(有一组直接死循环) |
③填 A[i].b < A[i-1].b |
错 11/14 |
④填 q < n && A[q].a <= r |
10/14 全部死循环 |
⑤填 q++ |
10/14 全部死循环(r
永远不动,while (r < m) 出不来) |
📝 ③ 为什么必须比 A[p-1] 而不是
A[i-1]:p-1
是已经保留下来的最后一个,i-1
是原数组里的前一个(可能刚被扔掉)。拿被扔掉的元素当基准,保留下来的序列就不再单调了。
⚠️ 注意 while (r < m) 这个大循环里,⑤
必须真的把 r 推大,否则永远出不去。贪心 +
while
的组合,第一件事就是确认「每轮循环里那个决定退出条件的变量确实在变大」。
📝 这道题(贪心区间覆盖)在复赛也是高频模型,见
L02_排序与贪心.md。
中国的国家顶级域名是()
A. .cn B. .ch C. .chn D. .china
答案:A
中国的国家顶级域名是 .cn。
📝 域名的层级从右往左:www.luogu.com.cn
里 .cn 是顶级域名(国家),.com
是二级,.luogu 是三级。
📝
常见顶级域名:.cn(中国)、.jp(日本)、.uk(英国)、.com(商业)、.org(组织)、.edu(教育)、.gov(政府)、.net(网络)。
二进制数 和 进行按位与运算的结果是()。
编者注:原题为“逻辑与”,但是根据题意应当是按位与。
A. B. C. D.
答案:D
按位与:两位都是 才得 ,逐位对齐算(程序核对):
  11 1011 1001 0111
& 01 0110 1110 1011
─────────────────────
  01 0010 1000 0011
⚠️ 四个选项的差别只在最后 4 位:A 是
1011、B 是 0011(但第 8 位不同)、C 是
0001、D 是
0011。必须逐位算完,不能只对前半截。
📝 建议按 4 位一组算,算完再合起来,比一位一位数不容易错行。
一个 位整型变量占用()个字节。
A. 32 B. 128 C. 4 D. 8
答案:C
位 位每字节 字节。
📝 必背的 sizeof 表(32/64
位常见平台):
| 类型 | 字节 |
|---|---|
char / bool |
1 |
short |
2 |
int / float |
4 |
long long / double |
8 |
若有如下程序段,其中
s、a、b、c
均已定义为整型变量,且 a、c
均已赋值(c 大于
)
s = a;
for (b = 1; b <= c; b++) s = s - 1;
则与上述程序段功能等价的赋值语句是()
A. s = a - c; B. s = a - b; C.
s = s - c; D. s = b - c;
答案:A
s = a;
for (b = 1; b <= c; b++) s = s - 1;
循环执行
次,每次 s 减
,所以最终
。
⚠️ 选项 C 的 s = s - c; 看着很像,但它用的是
s 的旧值——而题目里 s 在循环前刚被赋成
a,只有先写 s = a; 再写
s = s - c; 两句才等价。单独一条赋值语句要选
A。
📝 「与程序段功能等价」类题的做法:找出循环执行了多少次、每次改变多少,直接写出闭式。
设有 个已排好序的数据元素,采用折半查找时,最大比较次数为()
A. 7 B. 10 C. 6 D. 8
答案:A
折半查找 个元素,最多需要 次比较()。
📝 口诀: 个元素二分,最多 次。 常用值:,(CSP 2024 第 9 题考过),。
⚠️ 是 不是 ——虽然大多数时候结果一样,但在 恰好是 的幂时会差 。
链表不具有的特点是()
A. 插入删除不需要移动元素 B. 不必事先估计存储空间 C. 所需空间与线性表长度成正比 D. 可随机访问任一元素
答案:D
链表不能随机访问任一元素,只能从头顺着指针走。
📝 这题和 CSP 2020 第 7 题是同一道题(选项顺序换了),CSP 2022 第 4 题也是同一个考点。链表 vs 数组的对照表必须背熟:
| 数组 | 链表 | |
|---|---|---|
| 随机访问 | ✗ | |
| 中间插入删除 | ||
| 空间 | 需事先估计 | 动态增长 |
把 个同样的球放在 个同样的袋子里,允许有的袋子空着不放,问共有多少种不同的分法?()
提示:如果 个球都放在一个袋子里,无论是哪个袋子,都只算同一种分法。
A. 22 B. 24 C. 18 D. 20
答案:C
个相同的球放进 个相同的袋子、允许空 —— 因为袋子相同,这就是把 拆成至多 个正整数之和(不计顺序),即整数分拆。程序穷举得 18 种:
8        7+1      6+2      6+1+1    5+3     5+2+1
5+1+1+1  4+4      4+3+1    4+2+2    4+2+1+1 4+1+1+1+1
3+3+2    3+3+1+1  3+2+2+1  3+2+1+1+1
2+2+2+2  2+2+2+1+1
⚠️ 「袋子也是同样的」是全题的关键。 如果袋子不同(可区分),答案就是隔板法的 。题目还特意加了提示「无论放哪个袋子都算同一种分法」来强调这一点。
📝 整数分拆没有简单公式,考场上就老实按「最大的一份从 8 递减」有序枚举,这样不重不漏。
一棵二叉树如右图所示,若采用顺序存储结构,即用一维数组元素存储该二叉树中的结点(根结点的下标为
,若某结点的下标为
,则其左孩子位于下标
处、右孩子位于下标
处),则该数组的最大下标至少为()。
A. 6 B. 10 C. 15 D. 12
答案:C
按图,树的形状是:
        1
       / \
      2   3
         / \
        6   7
             \
15所以数组最大下标至少为 15。
📝 顺序存储二叉树的三个公式:左孩子 、右孩子 、父亲 。
⚠️ 这题考的是「顺序存储很浪费」:树只有 个结点,数组却要开到 。一条向右下斜的链会让下标指数级增长——这正是「完全二叉树才适合顺序存储」的原因。选项 A 的 就是给「按结点个数算」的人准备的。
以内最大的素数是()。
A. 89 B. 97 C. 91 D. 93
答案:B
以内最大的素数是 97。
验证其余选项: 是素数但不是最大;(这个最容易被误认为素数);。
📝 以内的 25 个素数背下来:
 2  3  5  7 11 13 17 19 23 29
31 37 41 43 47 53 59 61 67 71
73 79 83 89 97
⚠️ 是初赛的经典陷阱,它长得很像素数(不能被 2、3、5 整除)。判素数要试除到 ,别只试到 5。
和 的最大公约数是()。
A. 27 B. 33 C. 29 D. 31
答案:C
辗转相除(欧几里得算法):
📝
辗转相除背这一行:gcd(a,b) = b ? gcd(b, a%b) : a。(CSP
2025 第 16 题整道题就是围绕它出的。)
⚠️ 是素数,,。如果试着分解质因数也能做,但辗转相除快得多。
新学期开学了,小胖想减肥,健身教练给小胖制定了两个训练方案。
小胖每周周一到周四能抽出半小时跑步,周五到周日能抽出一小时跑步。
另外,教练建议小胖每周最多跑21公里,否则会损伤膝盖。
请问如果小胖想严格执行教练的训练方案,并且不想损伤膝盖,每周最多通过跑步消耗多少千卡?()
A. 3000 B. 2500 C. 2400 D. 2520
答案:C
先把「每公里能消耗多少千卡」算出来:
| 方案 | 距离 | 千卡 | 每公里 |
|---|---|---|---|
| 方案一(半小时) | 3 km | 300 | 100 |
| 方案二(1 小时) | 5 km | 600 | 120 ← 更划算 |
膝盖限制 21 公里是硬约束,所以要优先用「每公里千卡最高」的方案二。
已用程序穷举全部搭配确认 2400 是最大值。
⚠️ 注意周五~周日的 1 小时也可以跑两次方案一( km / 千卡),但那样每公里只有 千卡,在「公里数受限」的前提下更亏。这道题的核心是「受限资源是公里不是时间」。
⚠️ 选项 A 的 是「每天都跑满、不管 21 公里限制」的结果(,但要跑 公里)。
—副纸牌除掉大小王有 张牌,四种花色,每种花色 张。
假设从这 张牌中随机抽取 张纸牌,则至少()张牌的花色一致。
A. 4 B. 2 C. 3 D. 5
答案:A
鸽巢原理: 张牌分进 种花色,必有一种花色至少 张。
📝 鸽巢原理的标准形式: 个物品放进 个抽屉,必有一个抽屉至少 个。
⚠️ 注意问的是「至少」——即「无论怎么抽都保证能达到」的数。最坏情况是 (尽量平均),仍然有一种花色 张;而 只有 张,装不下 张。选 5 就错了,因为 这种抽法确实存在。
—些数字可以颠倒过来看,例如
颠倒过来还是本身,
颠倒过来是
,
颠倒过来看还是
,其他数字颠倒过来都不构成数字。
类似的,一些多位数也可以颠倒过来看,比如
颠倒过来是
。假设某个城市的车牌只由
位数字组成,每一位都可以取
到
。
请问这个城市最多有多少个车牌倒过来恰好还是原来的车牌?()
A. 60 B. 125 C. 75 D. 100
答案:C
能颠倒的数字只有 个:,,,,。
位车牌 倒过来仍是自己,要求 、、:
| 位置 | 约束 | 选择数 |
|---|---|---|
| ( 随之确定) | 任选可颠倒数字 | 5 |
| ( 随之确定) | 任选可颠倒数字 | 5 |
| (正中间) | 颠倒后必须是自己 → 只能是 | 3 |
已用程序穷举 00000~99999
全部十万个号码确认:恰好 75 个。
⚠️ 中间那一位是关键——它必须是「自反」的(),不能取 或 。漏掉这条会算成 ,正好是选项 B。
📝 题目说「每一位都可以取
到
」,所以允许前导零(00000
也算一个车牌)。
假设一棵二叉树的后序遍历序列为 ,中序遍历序列为 ,则其前序遍历序列为()。
A. B. C. D.
答案:B
后序 DGJHEBIFCA、中序 DBGEHJACIF:
A;中序里
A 左边 DBGEHJ 是左子树、右边 CIF
是右子树DGJHEB → 根 B;中序
DBGEHJ → 左 D、右 GEHJGEHJ 后序 GJHE → 根 E;中序
GEHJ → 左 G、右 HJHJ 后序 JH → 根 H,左孩子
JIFC → 根 C;中序
CIF → 右边 IF → 根 F,左孩子
I前序(根 → 左 → 右)= ABDEGHJCFI
📝 后序给根(在最后),中序分左右——和「前序给根(在最前)」是一套。
⚠️ 秒杀:前序第一个必是根
A,第二个必是左子树的根。 四个选项开头都是
AB,得比到第 5 位以后(ABDEG 之后 A 是
F、B 是 H、C 是 J、D 是
H)。这题必须老老实实建树。
以下哪个奖项是计算机科学领域的最高奖?()
A. 图灵奖 B. 鲁班奖 C. 诺贝尔奖 D. 普利策奖
答案:A
图灵奖是计算机科学领域的最高奖。鲁班奖是建筑工程奖。
📝 这题和 CSP 2021 第 2 题几乎一模一样——初赛常识题的重复率很高,把历年的常识题过一遍性价比极高。
二、阅读程序(程序输入不超过数组或字符串定义的范围;判断题正确填 √,错误填 ×;除特殊说明外,判断题 分,选择题 分,共计 分)
#include <cstdio>
#include <cstring>
using namespace std;
char st[100];
int main() {
    scanf("%s", st);
    int n = strlen(st);
    for (int i = 1; i <= n; ++i) {
        if (n % i == 0) {
            char c = st[i - 1];
            if (c >= 'a')
                st[i - 1] = c - 'a' + 'A';
        }
    }
    printf("%s", st);
    return 0;
} i = 1 改为
i = 0,程序运行时会发生错误。()i <= n 改为
i * i <= n,程序运行结果不会改变。()若输入的字符串长度为 ,那么输入的字符串跟输出的字符串相比,至多有()个字符不同。
若输入的字符串长度为(),那么输入的字符串跟输出的字符串相比,至多有 个字符不同。
(1)(1.5 分)
A. 正确 B. 错误
(2)(1.5 分)
A. 正确 B. 错误
(3)(1.5 分)
A. 正确 B. 错误
(4)(1.5 分)
A. 正确 B. 错误
(5)(3 分)
A. 18 B. 6 C. 10 D. 1
(6)(3 分)
A. 36 B. 100000 C. 1 D. 128
答案:(1) B (2) A (3) B (4) A (5) B (6) B
程序把「下标 能整除 」的那些位置上的小写字母改成大写( 是串长, 从 数起)。实测:
| 输入(长度) | 输出 |
|---|---|
abcdefghijkl (12) |
ABCDeFghijkL |
abcdefghijklmnopqr (18) |
ABCdeFghIjklmnopqR |
ABCDEF |
ABCDEF(原样) |
abc123 |
ABC123(数字原样) |
(1) 错误(B):程序对输入字符没有任何限制,实测
abc123 正常输出
ABC123,数字原样保留、不报错。
(2) 正确(A):改成 i = 0
后第一次就要算
n % 0——整数除以零。实测程序直接崩溃(退出码
0xC0000094,即 INTEGER_DIVIDE_BY_ZERO)。
📝 % 0 和 / 0
一样是致命错误,不是「结果为 0」。
(3) 错误(B):i * i <= n 只会跑到
,大于
的那些因数全被漏掉。实测 abcdefghijkl 从
ABCDeFghijkL 变成 ABCdefghijkl(位置 4、6、12
没被改)。
(4) 正确(A):if (c >= 'a')
对大写字母不成立(大写的 ASCII 都小于 'a' 的
97),所以一个都不改。实测 ABCDEF 原样输出。
(5) (B):至多改动的位置数 = 的因数个数。 的因数有 共 6 个。实测长度 18 的串正好有 6 个位置变了大写。
(6) (B):需要因数个数为 。, ✓(其余:、、,都不是 36)
⚠️ 这一小题在现实中跑不了——st[100]
只能装 99 个字符,长度
会溢出。题目问的是数学上的因数个数,不是程序真能处理的长度。
#include<cstdio>
using namespace std;
int n, m;
int a[100], b[100];

int main() {
    scanf("%d%d", &n, &m);
    for (int i = 1; i <= n; ++i)
        a[i] = b[i] = 0;
    for (int i = 1; i <= m; ++i) {
        int x, y;
        scanf("%d%d", &x, &y);
        if (a[x] < y && b[y] < x) {
            if (a[x] > 0)
                b[a[x]] = 0;
            if (b[y] > 0)
                a[b[y]] = 0;
            a[x] = y;
            b[y] = x;
        }
    }
    int ans = 0;
    for (int i = 1; i <= n; ++i) {
        if (a[i] == 0)
            ++ans;
        if (b[i] == 0)
            ++ans;
    }
    printf("%d", ans);
    return 0;
}
假设输入的 和 都是正整数, 和 都是在 的范围内的整数,完成下面的判断题和单选题:
++ans
时,
—定是偶数。()a[i] 和 b[i] 不可能同时大于
。()•选择题
(1)(1.5 分)
A. 正确 B. 错误
(2)(1.5 分)
A. 正确 B. 错误
(3)(1.5 分)
A. 正确 B. 错误
(4)(1.5 分)
A. 正确 B. 错误
(5)(3 分)
A. B. C. D.
(6)(3 分)
A. B. C. D.
答案:(1) A (2) B (3) B (4) B (5) A (6) A
程序维护一个「配对」关系:a[x] = y 与
b[y] = x 同步。新的
只有在「比
现有的配对更大、且比
现有的配对更大」时才接受,接受时把双方的旧配对拆掉。最后统计
a、b 里
的总个数。实测:
| 输入 | 输出 |
|---|---|
5 1 / 1 1 |
8 |
5 3 / 1 2 / 2 3 / 3 4 |
4() |
5 3 / 1 3 / 2 3 / 3 3 |
8() |
(1)
正确(A):
时第一对一定会被接受(此时
a[x] = b[y] = 0,而
,两个条件都成立),于是至少有一个位置非零,ans
必定小于
。实测最简的
5 1 / 1 1 输出
✓
(2) 错误(B):实测构造
5 1 / 1 3:
时 a[1]=3 非零不加,b[1]=0 加一,此刻
ans = 1 是奇数。程序统计中「ans 在第
27 行执行后为奇数」的时刻共出现 2 次。
📝 最终的 ans
一定是偶数(配对是对称的,a、b
里非零个数相等),但中途的 ans
不是——题目问的正是「执行完那一行时」。看清是「最后」还是「中途」。
(3) 错误(B):a[i] > 0 表示
作为左端被配对,b[i] > 0 表示
作为右端被配对,两者互不排斥。实测
5 1 / 1 1 有 1
个下标同时满足,5 3 / 1 2 / 2 3 / 3 4 有 2 个。
(4) 错误(B):实测构造
5 2 / 1 2 / 1 3(
恒小于
),第
15 行执行了 1 次。 第二对
被接受时 a[1] = 2 > 0,于是要去清掉旧配对
b[2] = 0——正是第 15 行。
📝 「 总小于 」并不能阻止同一个 被重复使用。 陷阱就在这里。
(5) (A): 个 两两不同、 个 两两不同 → 每一对都是全新的,全部被接受,配成 对。零的个数 。实测 输出 ✓
(6)
(A):
个
全相等(记作
)→
b[Y] 只能存一个
,所以最终只有一对配对成功。零的个数
。实测
输出
✓
#include <iostream>
using namespace std;
const int maxn = 10000;
int n;
int a[maxn];
int b[maxn];
int f(int l, int r, int depth) {
    if (l > r)
        return 0;
    int min = maxn, mink;
    for (int i = l; i <= r; ++i) {
        if (min > a[i]) {
            min = a[i];
            mink = i;
        }
    }
    int lres = f(l, mink - 1, depth + 1);
    int rres = f(mink + 1, r, depth + 1);
    return lres + rres + depth * b[mink];
}
int main() {
    cin >> n;
    for (int i = 0; i < n; ++i)
        cin >> a[i];
    for (int i = 0; i < n; ++i)
        cin >> b[i];
    cout << f(0, n - 1, 1) << endl;
    return 0;
}b[i] = i + 1,那么输出最大为()。b[i]=1,那么输出最小为()。(1)(1.5 分)
A. 正确 B. 错误
(2)(1.5 分)
A. 正确 B. 错误
(3)(3 分)
A. 5000 B. 600 C. 6 D. 100
(4)(3 分)
A. 100 B. 6 C. 5000 D. 600
(5)(3 分)
A. 386 B. 383 C. 384 D. 385
(6)(4 分)
A. 582 B. 580 C. 579 D. 581
答案:(1) B (2) A (3) A (4) D (5) D (6) B
程序在递归地建笛卡尔树:每次在区间里找最小的
a[i] 当根,左右分别递归,返回值是
。
⚠️ 后四小题(、 的最优/最坏)需要在所有可能的树形里取极值,无法靠原程序穷举。 我用区间 DP 复刻了同一个递推,并先在 的数据上与原程序对拍一致,再外推。
| 场景 | 实测 |
|---|---|
5 / 3 1 2 5 4 / 0 0 0 0 0 |
0(第 12 行比较 12 次) |
5 / 1 1 1 1 1 / 1 2 3 4 5 |
55,未报错 |
链状(a 递增) |
第 12 行比较 5050 次 |
| 平衡 | 第 12 行比较 580 次 |
(1) 错误(B):if (min > a[i])
用的是严格大于,遇到相等不更新,取第一个最小值即可,不会出错。实测全
的 a 数组正常输出
。
(2) 正确(A):返回值是
,b
全
时每项都是
。实测输出
✓
(3)
(A):最坏是链状(a
单调),每层区间只缩短
,比较次数
,最接近
。
(4) (D):最好是平衡,每一层所有区间加起来约 次比较,共 层。实测平衡形态下正好是 580 次,最接近 。
📝 (3)(4) 其实就是快速排序的最坏 与最好 ——这个程序的结构和快排完全一样(选一个「基准」再分两半)。
(5)
(D):、b[i] = i+1,DP
求最大值得 385。实测用「a
递增」(链状、右偏)的构造正好达到 385。
(6)
(B):、b
全
,此时返回值就是所有结点的深度之和,最小当然是平衡树。DP
求得 580——和第 (4)
小题的比较次数是同一个数,因为「每层的比较次数总和」正好等于「该层结点数」的累加方式。
📝 这两个数字相等不是巧合: 和第 12 行的总比较次数在这个算法里是同一个量。发现这一点,(4) 和 (6) 可以互相验证。
1.(矩阵变幻)有一个奇幻的矩阵,在不停的变幻,其变幻方式为:
数字 变成矩阵
0 0
0 1
数字 变成矩阵
1 1
1 0
最初该矩阵只有一个元素 ,变幻 次后,矩阵会变成什么样?
例如,矩阵最初为:;
矩阵变幻 次后:
0 0
0 1
矩阵变幻 次后:
0 0 0 0
0 1 0 1
0 0 1 1
0 1 1 0
输入一行一个不超过 的正整数 。输出变幻 次后的矩阵。
试补全程序。
提示:
<< 表示二进制左移运算符,例如
<<
;
而 ^
表示二进制异或运算符,它将两个参与运算的数中的每个对应的二进制位—进行比较,若两个二进制位相同,则运算结果的对应二进制位为
,反之为
。
#include <cstdio>
using namespace std;
int n;
const int max_size = 1 << 10;

int res[max_size][max_size];

void recursive(int x, int y, int n, int t) {
    if (n == 0) {
        res[x][y] = ①;
        return;
    }
    int step = 1 << (n - 1);
    recursive(②, n - 1, t);
    recursive(x, y + step, n - 1, t);
    recursive(x + step, y, n - 1, t);
    recursive(③, n - 1, !t);
}

int main() {
    scanf("%d", &n);
    recursive(0, 0, ④);
    int size = ⑤;
    for (int i = 0; i < size; i++) {
        for (int j = 0; j < size; j++)
            printf("%d", res[i][j]);
        puts("");
    }
    return 0;
}
①处应填()
②处应填()
③处应填()
④处应填()
⑤处应填()
(1)(3 分)
A. n%2 B. 0 C. t D.
1
(2)(3 分)
A. x-step,y-step B. x,y-step C.
x-step,y D. x,y
(3)(3 分)
A. x-step,y-step B. x+step,y+step C.
x-step,y D. x,y-step
(4)(3 分)
A. n-1,n%2 B. n,0 C. n,n%2 D.
n-1,0
(5)(3 分)
A. 1<<(n+1) B. 1<<n C.
n+1 D. 1<<(n-1)
答案:① C ② D ③ B ④ B ⑤ B
分形矩阵:每次把矩阵变成 块,其中左上、右上、左下三块保持类型 ,右下一块取反 。
| 空 | 填 | 为什么 |
|---|---|---|
| ① | t |
递归到最底层()时,格子的值就是当前类型 |
| ② | x, y |
左上块,坐标不变 |
| ③ | x + step, y + step |
右下块 |
| ④ | n, 0 |
从完整的 层、类型 开始 |
| ⑤ | 1 << n |
变换 次后边长是 |
实测 的输出与题面给的例子逐字一致:
0000
0101
0011
0110错误填法实测:
| 改动 | 实测 |
|---|---|
①填 0 |
全是 0(类型信息丢了) |
③填 x - step, y - step |
崩溃(负下标) |
⑤填 1 << (n-1) |
只打印了左上角四分之一 |
📝 这题的分形规律要从题面给的例子反推: 变成「三个 加一个 」, 变成「三个 加一个 」——都是右下角那块取反,其余三块照抄。看出这一点,②③ 就定了。
📝 顺带认识:这个矩阵的第
行第
列,其实就是
与
按位异或后
的个数的奇偶性(提示里给 ^ 的说明就是暗示)。
2.(计数排序)计数排序是一个广泛使用的排序方法。下面的程序使用双关键字计数排序,将 对 以内的整数,从小到大排序。
例如有三对整数 、、,那么排序之后应该是 、、 。
输入第一行为 ,接下来 行,第 行有两个数 和 ,分别表示第 对整数的第一关键字和第二关键字。
从小到大排序后输出。
数据范围 ,。
提示:应先对第二关键字排序,再对第一关键字排序。数组
ord[] 存储第二关键字排序的结果,数组 res[]
存储双关键字排序的结果。
试补全程序。
#include <cstdio>
#include <cstring>
using namespace std;
const int maxn = 10000000;
const int maxs = 10000;

int n;
unsigned a[maxn], b[maxn],res[maxn], ord[maxn];
unsigned cnt[maxs + 1];
int main() {
    scanf("%d", &n);
    for (int i = 0; i < n; ++i)
        scanf("%d%d", &a[i], &b[i]);
    memset(cnt, 0, sizeof(cnt));
    for (int i = 0; i < n; ++i)
        ①; // 利用 cnt 数组统计数量
    for (int i = 0; i < maxs; ++i)
        cnt[i + 1] += cnt[i];
    for (int i = 0; i < n; ++i)
        ②; // 记录初步排序结果
    memset(cnt, 0, sizeof(cnt));
    for (int i = 0; i < n; ++i)
        ③; // 利用 cnt 数组统计数量
    for (int i = 0; i < maxs; ++i)
        cnt[i + 1] += cnt[i];
    for (int i = n - 1; i >= 0; --i)
        ④ // 记录最终排序结果
    for (int i = 0; i < n; i++)
        printf("%d %d", ⑤);

    return 0;
}
①处应填()
②处应填()
③处应填()
④处应填()
⑤处应填()
(1)(3 分)
A. ++cnt[i] B. ++cnt[b[i]] C.
++cnt[a[i] * maxs + b[i]] D. ++cnt[a[i]]
(2)(3 分)
A. ord[--cnt[a[i]]] = i B.
ord[--cnt[b[i]]] = a[i] C.
ord[--cnt[a[i]]] = b[i] D.
ord[--cnt[b[i]]] = i
(3)(3 分)
A. ++cnt[b[i]] B. ++cnt[a[i] * maxs + b[i]]
C. ++cnt[a[i]] D. ++cnt[i]
(4)(3 分)
A. res[--cnt[a[ord[i]]]] = ord[i] B.
res[--cnt[b[ord[i]]]] = ord[i] C.
res[--cnt[b[i]]] = ord[i] D.
res[--cnt[a[i]]] = ord[i]
(5)(3 分)
A. a[i], b[i] B. a[res[i]], b[res[i]] C.
a[ord[res[i]]],b[ord[res[i]]] D.
a[res[ord[i]]],b[res[ord[i]]]
答案:① B ② D ③ C ④ A ⑤ B
双关键字计数排序:先按第二关键字 b
排一遍(结果放 ord),再按第一关键字 a
排一遍(结果放 res)。
| 空 | 填 | 为什么 |
|---|---|---|
| ① | ++cnt[b[i]] |
先统计第二关键字 |
| ② | ord[--cnt[b[i]]] = i |
按 b 排好,ord
里存的是原下标 |
| ③ | ++cnt[a[i]] |
再统计第一关键字 |
| ④ | res[--cnt[a[ord[i]]]] = ord[i] |
按 ord 的顺序、以 a 为键再排一次 |
| ⑤ | a[res[i]], b[res[i]] |
res 存的是原下标,回原数组取值 |
实测(题面自带的例子 应输出 ):
| 填法 | 实测 |
|---|---|
| 标准答案 | (2,4) (3,3) (3,4) ✓,另两组随机数据也完全有序 |
①填 ++cnt[a[i]] |
(2,4) (3,4) (3,3) ✗ 第二关键字没排 |
②填 ord[--cnt[a[i]]] = i |
崩溃(下标溢出) |
④填 res[--cnt[b[i]]] = ord[i] |
(3,4) (3,3) (2,4) ✗ 完全乱 |
⑤填 a[i], b[i] |
原样输出,根本没排序 |
📝 为什么必须「先排第二关键字、再排第一关键字」:计数排序是稳定的,第二遍排序会保留第一遍的相对顺序。倒过来做(先排第一再排第二)就会把第一关键字的顺序毁掉。
⚠️ ④ 的 for (int i = n - 1; i >= 0; --i)
是倒着走的,配合 --cnt[...]
才能保证稳定。正着走会把相同 a
值的那一组顺序倒过来,稳定性就没了。
📝 计数排序的三步骨架背下来:① 数每个值出现几次 → ②
求前缀和得到「每个值的末位置」 → ③
从后往前扫原数组,--cnt[key]
定位并填入。(见 S3_计数排序与手写排序.md。)